Xiaomi-OCR-0入門:Qwenから育てた0.8Bの文書特化モデル
スキャンした資料や数式入りの論文を、編集できる内容に変えたい。その候補になるのが、小米の Xiaomi-OCR-0 です。0.8Bパラメータの視覚言語モデルで、文書解析、項目抽出、画像内の文字に関する質問応答を扱います。
学習の出発点は Qwen3.5-0.8B-Base。約 1億7,000万件(170M)のOCR向けサンプルで、文書処理に特化させています。「一般教養のある新人を、書類に強い担当者に育てる」と考えると、学習の流れがつかみやすくなります。公式モデルカードに沿って、仕組み、成績、ローカルで試す順序を見ていきましょう。
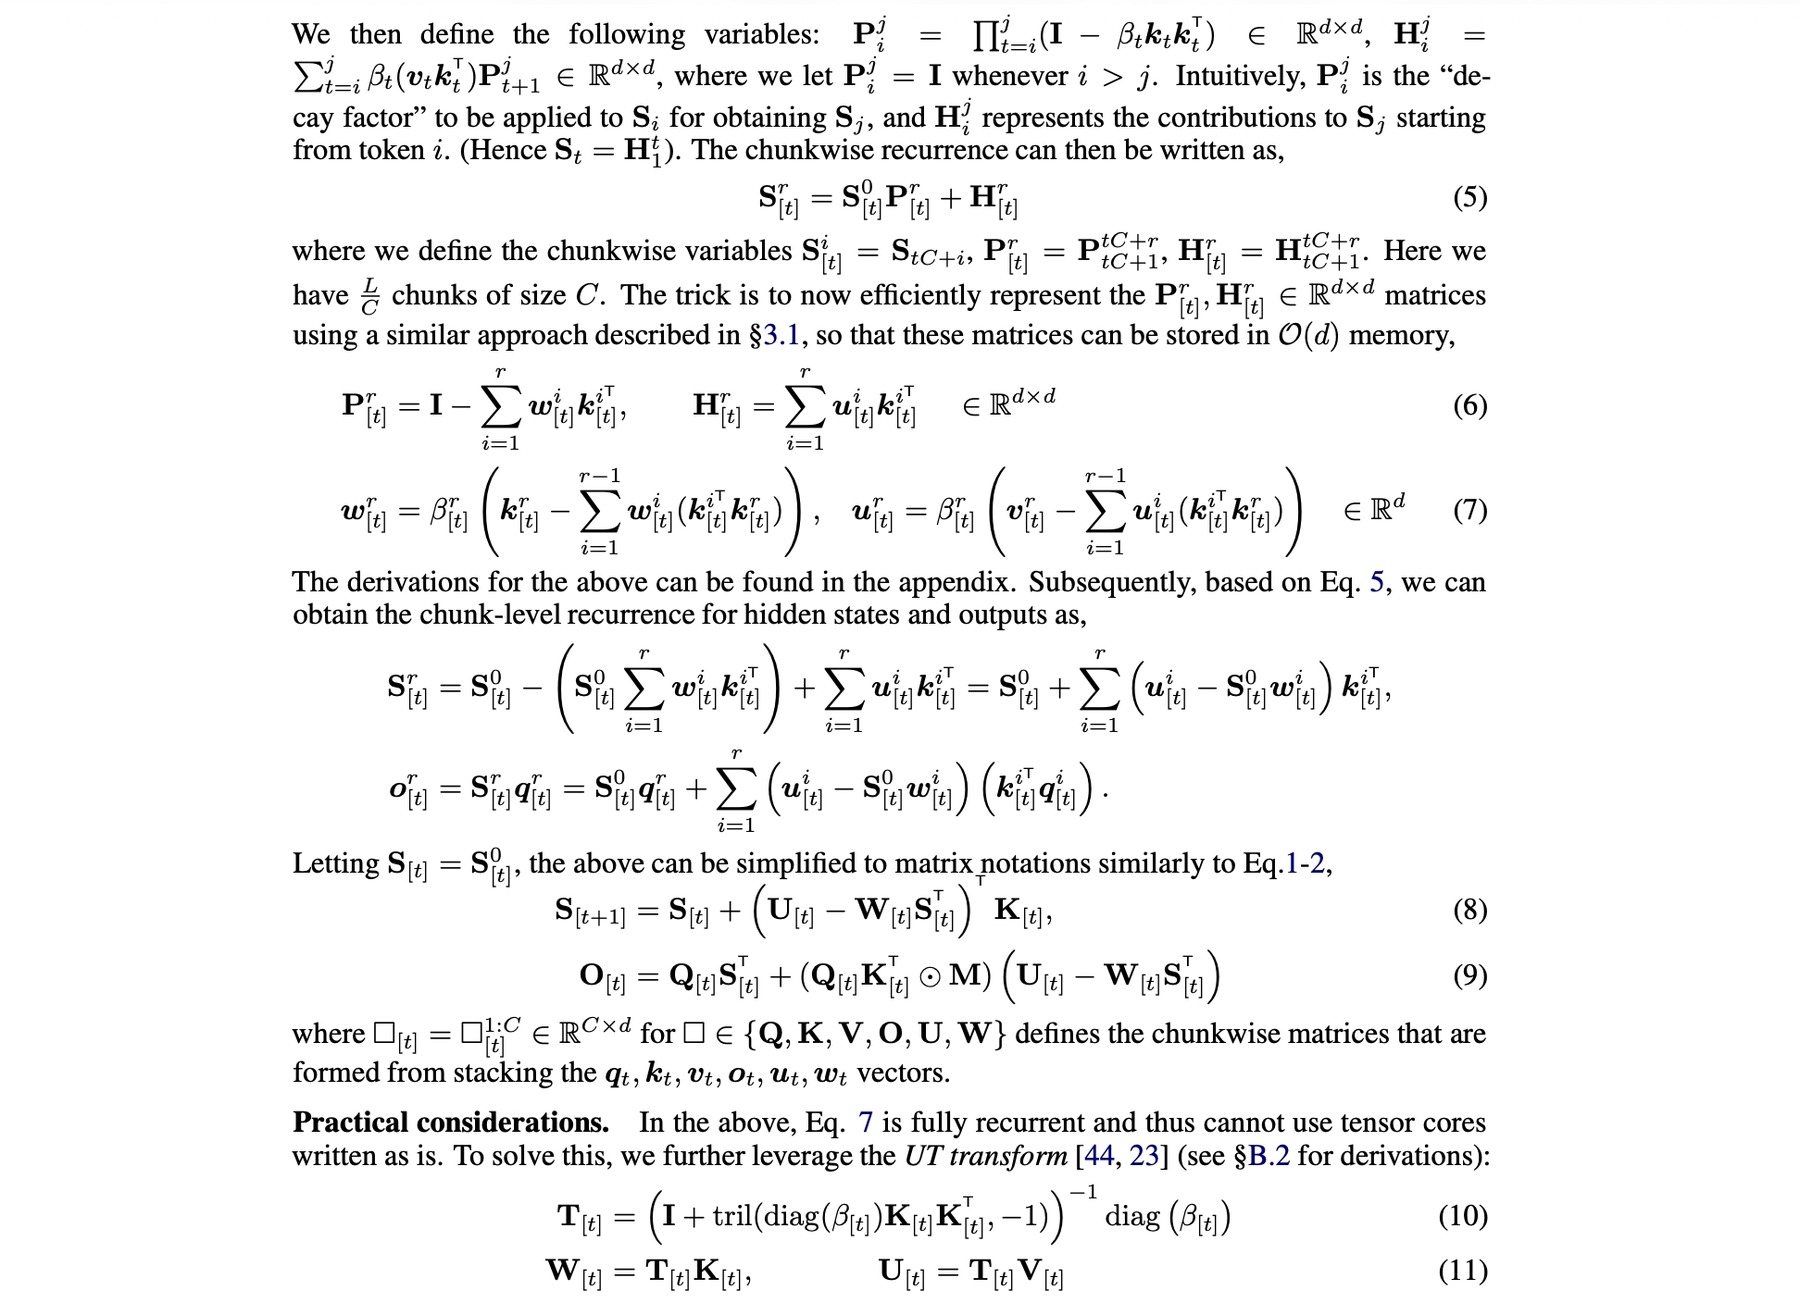
出典:公式 example_pics/dense-equations.jpg。入力画像の例で、3言語版共通のカバーにも使用しています。
最初に確認したい3つの用途
| 用途 | 入力 | 得たい結果 |
|---|---|---|
| 文書解析 | 論文、スキャン、撮影したページ | 読み順に並んだ本文、表、数式 |
| KIE:重要項目の抽出 | 文書画像と必要な項目 | 指定したJSON形式などの構造化データ |
| OCR-VQA:文字を含む画像への質問 | 文書画像と質問 | 文書の内容に基づく回答 |
公式はスキャン、ゆがみ、撮影、傾きのある文書への対応を説明し、歴史的な手書き文字や書道の成績も掲載しています。同じ小型モデルで、内容を書き起こす作業から項目を探す作業まで扱える点が特徴です。
まずはページ全体の解析から始めると分かりやすいでしょう。公式Transformersサンプルもこの形式です。Ollamaガイドには領域モードもありますが、追加のlayout依存関係が必要です。
Qwenからどう育てたのか
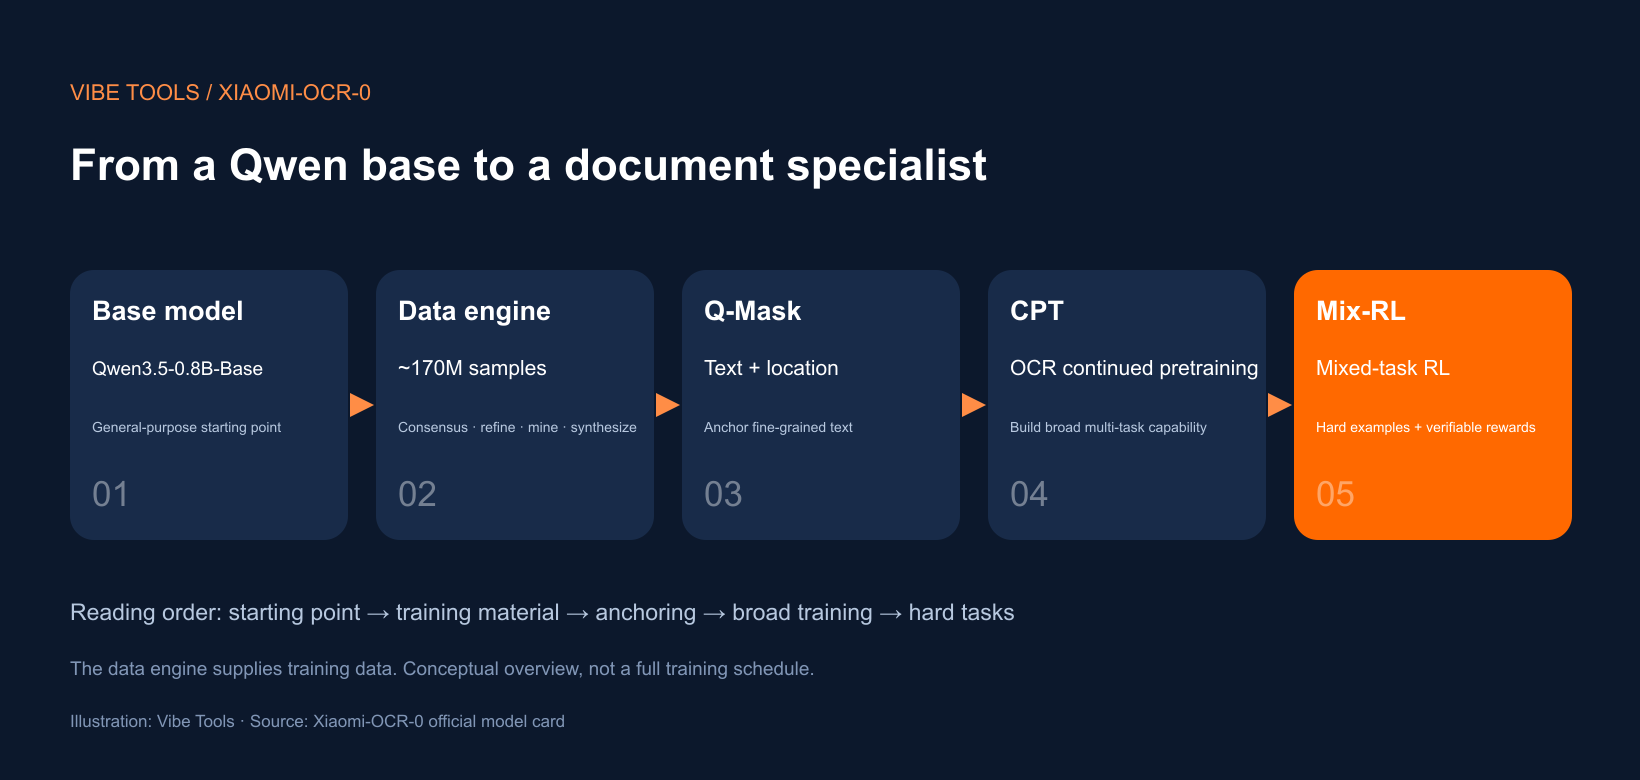
Vibe Toolsが公式モデルカードを基に作成。矢印は説明の順序を示し、データエンジンは学習用の教材を供給します。
出発点:一般教養のある新人を迎える
Qwen3.5-0.8B-Baseを基に追加学習するのが基本です。すでに持つ能力を生かしながら、OCRや文書理解に適したモデルへ調整します。
新人の例なら、一般的な知識を持つ人に、契約書、論文、伝票の扱いを覚えてもらう段階です。「基盤モデルには文書を読む能力が一切ない」という意味ではありません。仕事に合わせて得意分野を育てます。
データエンジン:正しい教材と解答をそろえる
約170M件のサンプルは、文書解析とOCRに関する理解タスクを含みます。大量に集めるだけでなく、文字、表、数式に信頼できる正解を付けることが大切です。
公式の仕組みを、新人研修に置き換えると次のようになります。
- 複数の先生に解答を作ってもらう。 異なる専門モデルが候補ラベルを生成します。ETC(三者合意)は専門家プール全体の一致度で候補を順位付けし、3つの専門家が合意する部分集合を選びます。不確かなサンプルは追加の精査へ回します。単純な多数決だけを指す仕組みではありません。
- 解答を画像に戻して照合する。 意見が割れた候補を再描画し、元画像の領域と比較します。表の行列や数式の構造の誤りを、学習前に見つけやすくします。
- 役立つ練習問題を選ぶ。 専門家の一致度、モデルの自己一貫性、意味によるクラスタリング、確認済みの失敗パターンを組み合わせます。
- 不足と苦手を補う問題を作る。 カバレッジ重視の合成は構造、スタイル、字形、分野の不足を補い、失敗重視の合成は繰り返す誤りを狙います。
専門家として挙げられているのは、PaddleOCR-VL-1.6、MinerU2.5-Pro、GLM-OCR、dots.mocr、HunyuanOCR-1.5、TeleOCR、OvisOCR2、Qianfan-OCRです。教材を共同で整え、疑わしい解答を確認し、苦手な問題を追加する仕組みと考えられます。
Q-Mask:何と書いてあるか、どこにあるかを結び付ける
Q-Maskの目的は、細かな文字情報と位置を対応させることです。
金額を書き写せても、原本のどの位置にあるか分からなければ、項目抽出や表のセルの区別で困ります。新人に「答えと、その場所を一緒に示して」と教えるイメージです。具体的な方式は技術レポートで確認できます。
CPT:文書処理を幅広く練習する
CPTは継続事前学習です。OCRを中心に、複数タスクの基礎能力を作ります。
文字、表、数式、文書への質問を一通り練習する研修に当たります。特定の難問へ進む前に、共通の土台を整える段階です。
Mix-RL:難しい問題を、確かめられる報酬で学ぶ
Mix-RLは複数タスクを混ぜた強化学習で、難しいサンプルに検証可能な報酬を使います。
幅広い研修の後に、採点できる難しい実務課題へ進むと考えると分かりやすいでしょう。CPTが基礎を作り、Mix-RLが難しいケースでの能力を高めます。
成績は用途ごとに読む
以下の数値と順位は、公式モデルカードに掲載されたものです。
| ベンチマーク | Xiaomi-OCR-0の成績 | 主な対象 |
|---|---|---|
| OmniDocBench v1.6 | 96.83、2位 | 文書解析 |
| Wild-OmniDocBench | 87.94、2位 | 難しい実環境の文書解析 |
| Real5-OmniDocBench | 95.24、1位 | 文書解析 |
| UniMER-Test | 97.84 | 数式認識 |
| PubTabNet | 92.27 | 表認識 |
| Chronicles-OCR Mature Scripts | 73 | 隷書・草書・行書・楷書など。Seed 2.0 Proは72 |
| OCR-VQAの5指標平均 | 83.2 | DocVQA、InfoVQA、ChartQA、OCRBench、TextVQA |
文書解析の比較
| モデル | パラメータ数 | OmniDocBench v1.6 ↑ | Real5 ↑ | Wild ↑ |
|---|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 96.83 | 95.24 | 87.94 |
| TeleOCR | 1.2B | 96.87 | — | 88.53 |
| OvisOCR2 | 0.8B | 96.58 | 92.29 | 87.91 |
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 93.19 | 87.36 |
| MinerU2.5-Pro | 1.2B | 95.75 | 88.94 | 87.33 |
| GLM-OCR | 0.9B | 95.22 | 90.32 | 85.08 |
↑は高いほど良い指標です。「—」は元表に記載がない項目、太字はXiaomi-OCR-0を示します。
Qwenとの理解タスク比較
| モデル | DocVQA | InfoVQA | ChartQA | OCRBench | TextVQA | 平均 |
|---|---|---|---|---|---|---|
| Qwen3.5-0.8B | 88.5 | 60.3 | 69.5 | 77.9 | 68.3 | 72.9 |
| Qwen3.5-2B | 92.4 | 72.4 | 77.0 | 85.9 | 76.9 | 80.9 |
| Xiaomi-OCR-0 | 93.1 | 75.1 | 84.6 | 84.6 | 78.6 | 83.2 |
平均は0〜100スケールの5指標の算術平均です。Xiaomi-OCR-0はQwen3.5-2Bの平均を上回りますが、全項目で勝つわけではありません。OCRBenchは84.6で、Qwen3.5-2Bの85.9を下回ります。
学習段階の比較で分かること
| 学習結果 | 解析Overall:OmniDocBench v1.6 | 理解Overall:VQAの5指標平均 |
|---|---|---|
| 0.8B CPT | 96.4739 | 78.1 |
| 0.8B MOPD | 96.7417 | 82.7 |
| 0.8B Mix-RL | 96.8277 | 83.2 |
| 4Bのタスク別教師 | 96.9745 | 88.1 |
CPTからMix-RLで、解析は96.4739から96.8277へ、理解は78.1から83.2へ上がっています。MOPDは解析教師と理解教師を1つずつ使う比較手法です。収束は速く、より長く学習したMix-RLはさらに高い到達点を示しました。
4B教師と0.8B生徒の差は、理解で約4.9ポイント、解析で約0.15ポイントです。ただし教師は各タスク専用、生徒は両タスクを学びます。同じタスクのデータ量はそろえてありますが、差のすべてをパラメータ数だけで説明することはできません。
理解データを加える時期にも違いがありました。解析データの9%、29%、50%を使う各段階で、その段階の解析ベースラインに対する変化は−0.330、+0.639、+0.0749です。この実験では、解析能力が十分育った後に理解データが役立っています。
ローカルで試す手順
まず、人の目で確認できる1枚を選びます。文字だけでなく、数式の構造や読み順も見てから処理量を増やしましょう。公式の入力例には、次のような手書きの数式もあります。
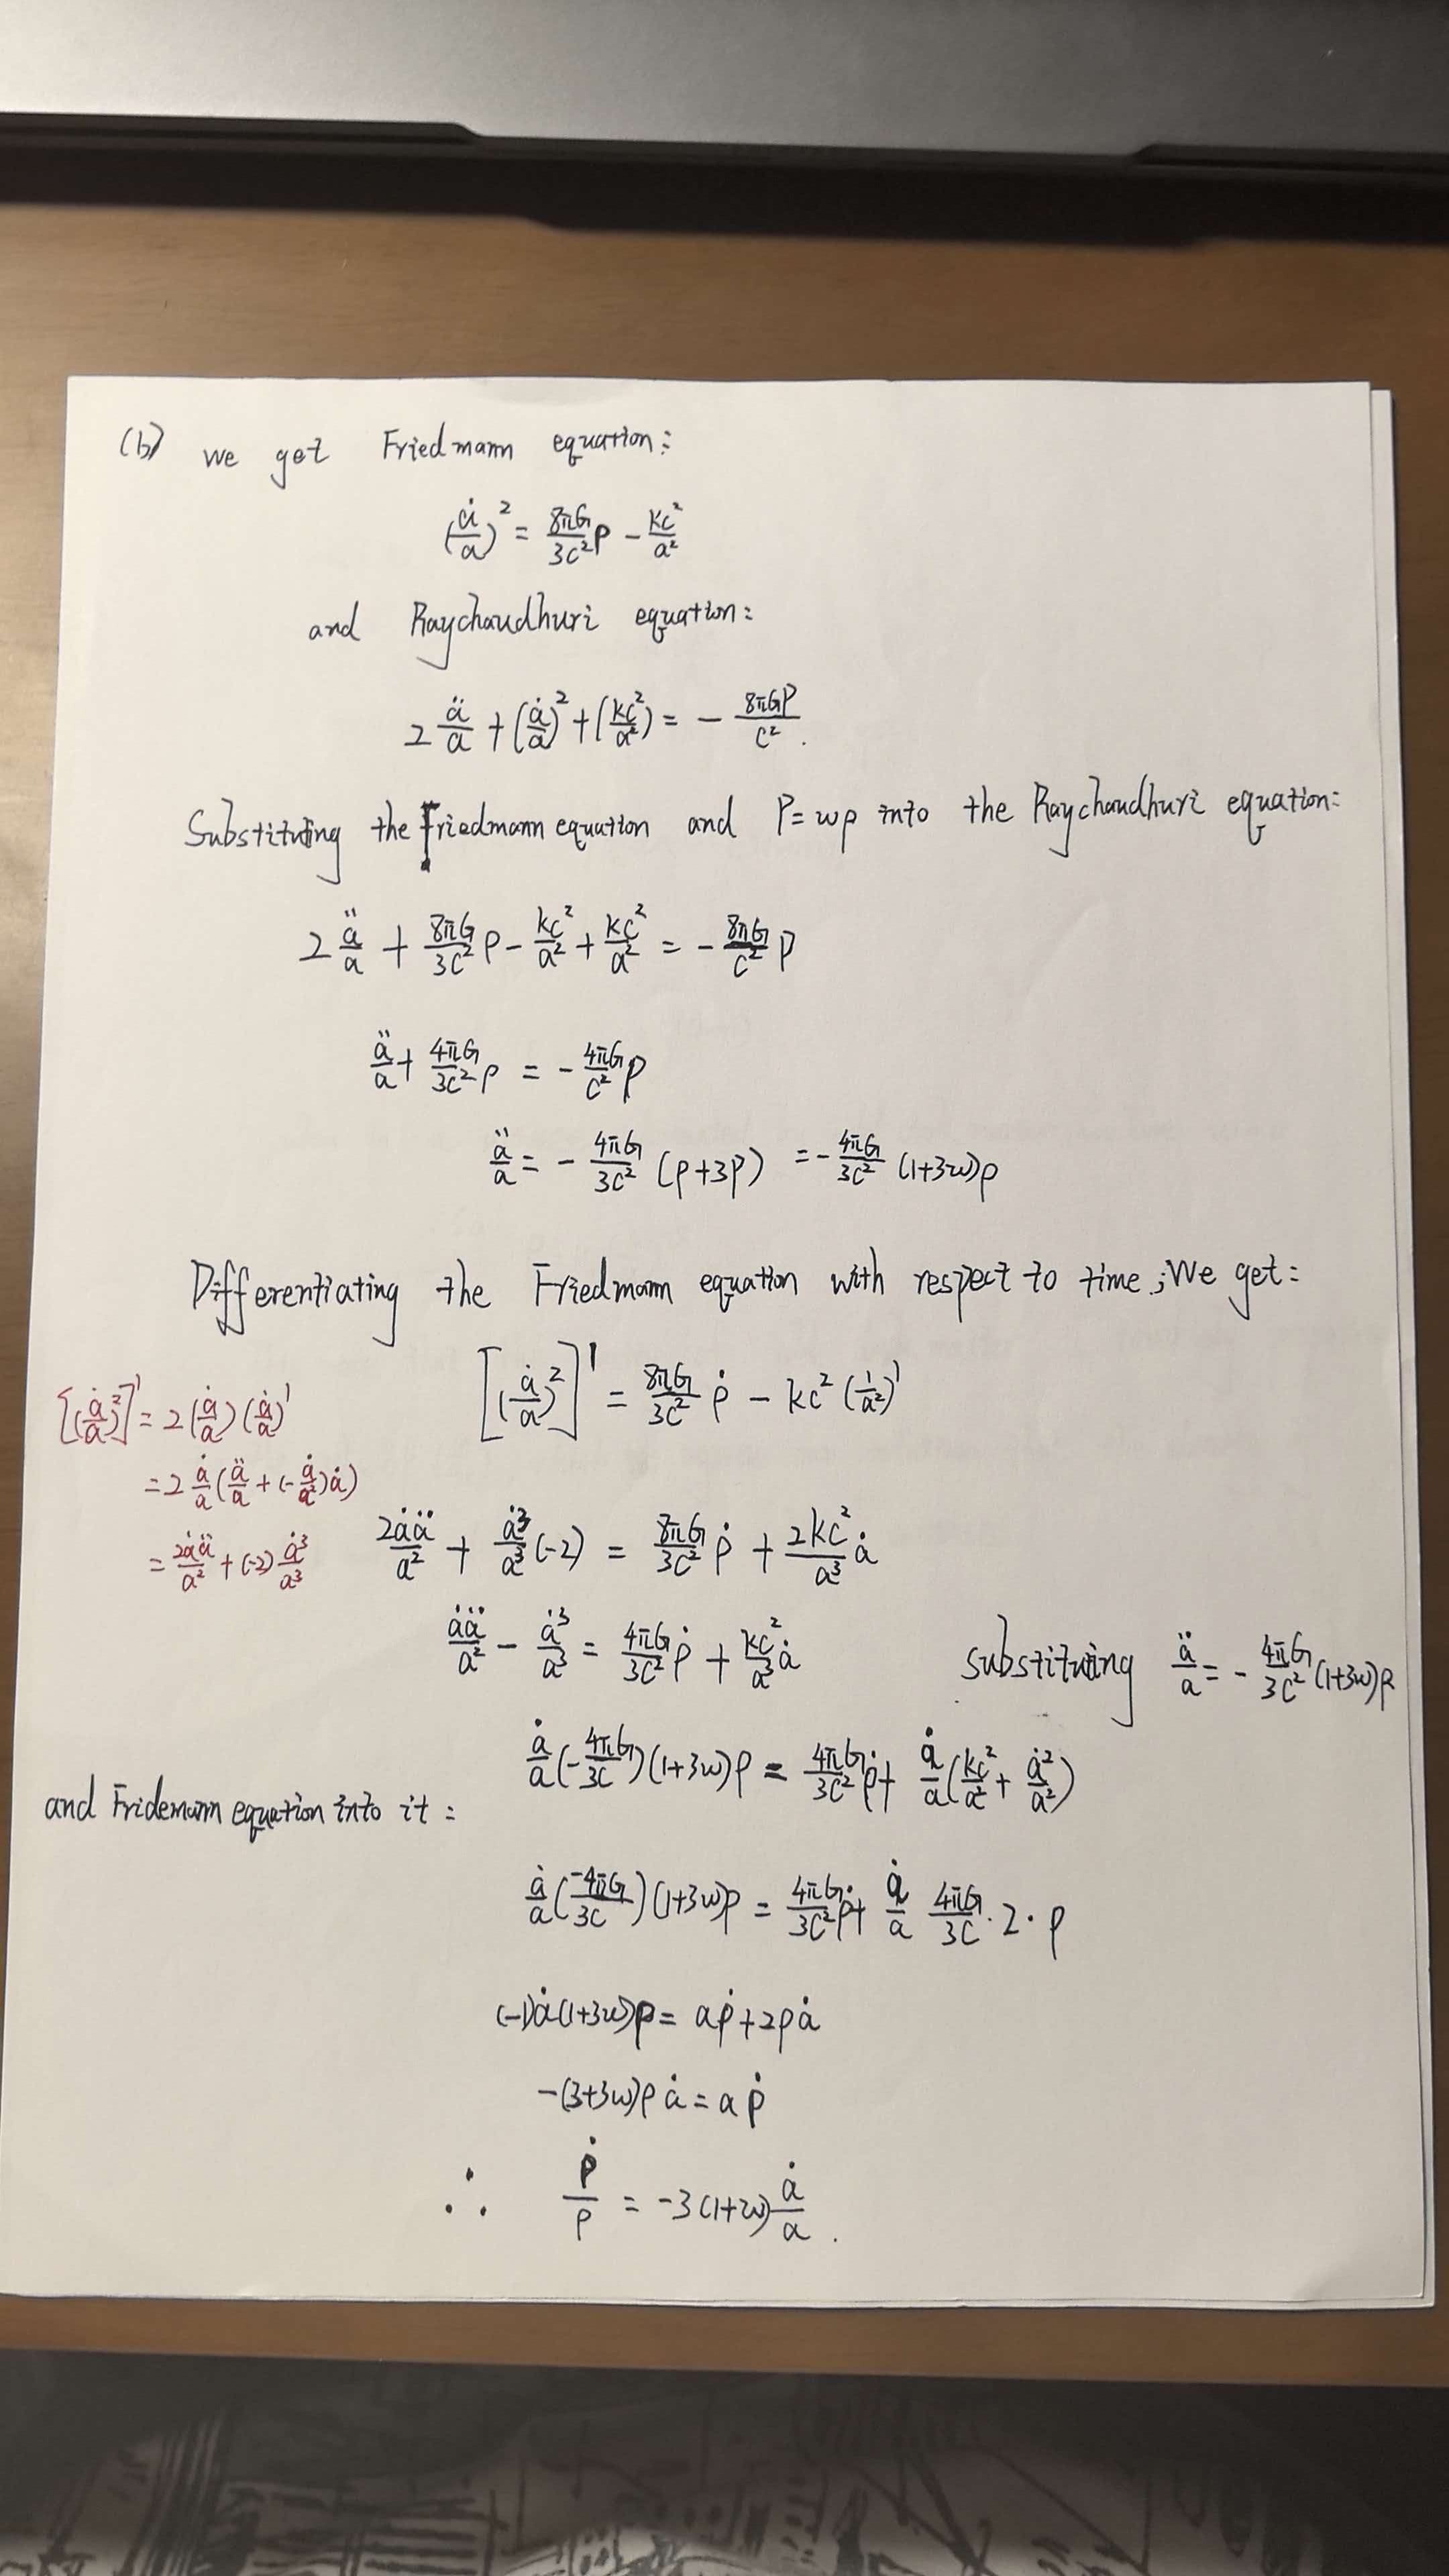
出典:公式 example_pics/handwrite-formula.jpg。入力例です。解析後の出力はモデルカードに掲載されています。
Ollamaを使う場合
公式はOllama対応を実験的としています。Ollamaをインストールして起動し、テキストモデルと視覚プロジェクターを含む約1.8 GBのコミュニティBF16パッケージを取得します。
ollama pull longwayxu/xiaomi-ocr-0:bf16
続いて公式リポジトリのOllamaガイドで、MCPサービスまたはブラウザーDemoを設定します。これらは画像前処理、非思考プロンプト、デコード設定を自動で適用します。pullだけでは、この設定は入りません。 ガイドはPDF解析、KIE、VQAも扱い、領域モードには追加のlayout依存関係が必要です。
Transformersでページ全体を解析する場合
モデルカードに掲載されたバージョンの組み合わせを使います。
uv venv --python 3.13
source .venv/bin/activate   # Windows: .venv\Scripts\activate
uv pip install "transformers==5.17.0" "torch==2.14.0" "torchvision==0.29.0" pillow
次のコードを ocr_demo.py として保存し、python ocr_demo.py を実行します。この記事で参照する公式リポジトリIDを使い、公式サンプル画像をダウンロードする構成です。自分の画像では IMAGE をローカルパスへ置き換えます。
import torch
from huggingface_hub import hf_hub_download
from transformers import AutoModelForImageTextToText, AutoProcessor

MODEL = "xiaomi-research/Xiaomi-OCR-0"
# Choose "qianziwen.jpeg" or "dense-equations.jpg".
IMAGE = hf_hub_download(
    repo_id=MODEL,
    filename="example_pics/qianziwen.jpeg",
)
PROMPT = (
    "Extract all information from the main body of the document image and represent it "
    "in markdown format, ignoring headers and footers. Tables should be expressed in OTSL "
    "format, formulas in the document should be represented using LATEX format, and the "
    "parsing should be organized according to the reading order."
)

device = (
    "cuda" if torch.cuda.is_available()
    else "mps" if torch.backends.mps.is_available()
    else "cpu"
)
dtype = torch.float32 if device == "cpu" else torch.float16
processor = AutoProcessor.from_pretrained(MODEL)
model = AutoModelForImageTextToText.from_pretrained(
    MODEL, dtype=dtype,
).to(device).eval()

messages = [{
    "role": "user",
    "content": [
        {"type": "image", "url": IMAGE},
        {"type": "text", "text": PROMPT},
    ],
}]
inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
)
inputs = inputs.to(device)

with torch.inference_mode():
    output = model.generate(**inputs, max_new_tokens=4096, do_sample=False)

new_tokens = output[:, inputs["input_ids"].shape[1]:]
print(processor.batch_decode(new_tokens, skip_special_tokens=True)[0])
出力は読み順に整理され、数式はLaTeX、表はOTSLで表されます。OTSLは表構造の表現形式なので、通常のMarkdown表とは区別してください。長いページで出力が途中までになる場合は、例の max_new_tokens=4096 も確認します。
別の配布形式へ移る前のチェック
- 視覚プロジェクターがあるか。 prithivMLmodsのGGUFには
Xiaomi-OCR-0.mmproj-bf16.ggufが別途必要です。xzl01のパッケージはF16プロジェクターを使います。 - 推論設定が適用されているか。 OllamaのMCPとDemoは対応しますが、重みの取得だけでは設定されません。
- 変換版の情報を確認したか。 公式は上記コミュニティGGUFの精度を評価していません。元モデルの点数をそのまま当てはめず、NInfer BF16の速度や出力比較も各配布ページで確認します。
文書を構造化するなら、まずページ全体の解析から。項目を取り出したいなら、1枚の出力を確認した後に、JSON schemaを指定するKIEへ進むと用途を切り分けやすくなります。
公式リンク
- Xiaomi-OCR-0モデルカード:学習、成績、入力・出力例、Apache 2.0ライセンス。
- GitHubリポジトリ:プロジェクトの説明。
- Ollamaガイド:MCP、Demo、領域モードの設定。
- 技術レポート:データエンジンと学習実験の詳細。
最新の記事
Vibe Coding Tools チームによる比較・レビュー・ワークフローの最新インサイト。
DeepSeek Super AgentのRouter・Worker・子エージェントの分担、向いている人、3ステップの始め方を解説。テスト用プロジェクトで小さな依頼を出し、結果を確認する流れが分かります。
Dessa は今使えるのか。Block の公式録音の聴き方と四つの想定用途を紹介し、一般公開、モデル配布、API、日本語対応、ローカル実行の確認点を整理します。
エディタ、ターミナル、モデル設定、クラウド開発に分けて AI ツールを比較。公式資料と Next.js で試せる評価手順を紹介します。