Dessa AI Voice Model の公開状況と公式デモ 想定用途を整理
AI で生成したイメージ図です。製品画面や性能測定の結果ではありません。
Dessa を試したい場合、最初に確認するべきなのは公開範囲です。2026 年 10 月 28 日時点では、Block の公式ページで会話の録音を聴けます。一方、一般ユーザー向けに自由に話しかけられる画面、利用できるモデルのダウンロード、公開 API は確認できません。少数の AI 安全性研究者を対象とする早期アクセスの案内はあります。公式ページ
Dessa は、相手の話を聞きながら発話する全二重の音声対話モデルとして紹介されています。相づち、間、笑い、声の調子などが注目されていますが、録音が自然に聞こえることと、必要な作業に使えることは別の確認事項です。まず現在できる試聴方法を紹介し、その後に用途ごとの見方を整理します。
公式デモを試聴する手順
以下で操作するのは録音プレーヤーです。マイクを有効にしたり、自分の音声をアップロードしたりする必要はありません。
1 公式の会話録音を開く
Talking about the release を開き、二人分の音声トラックと再生ボタンを確認します。
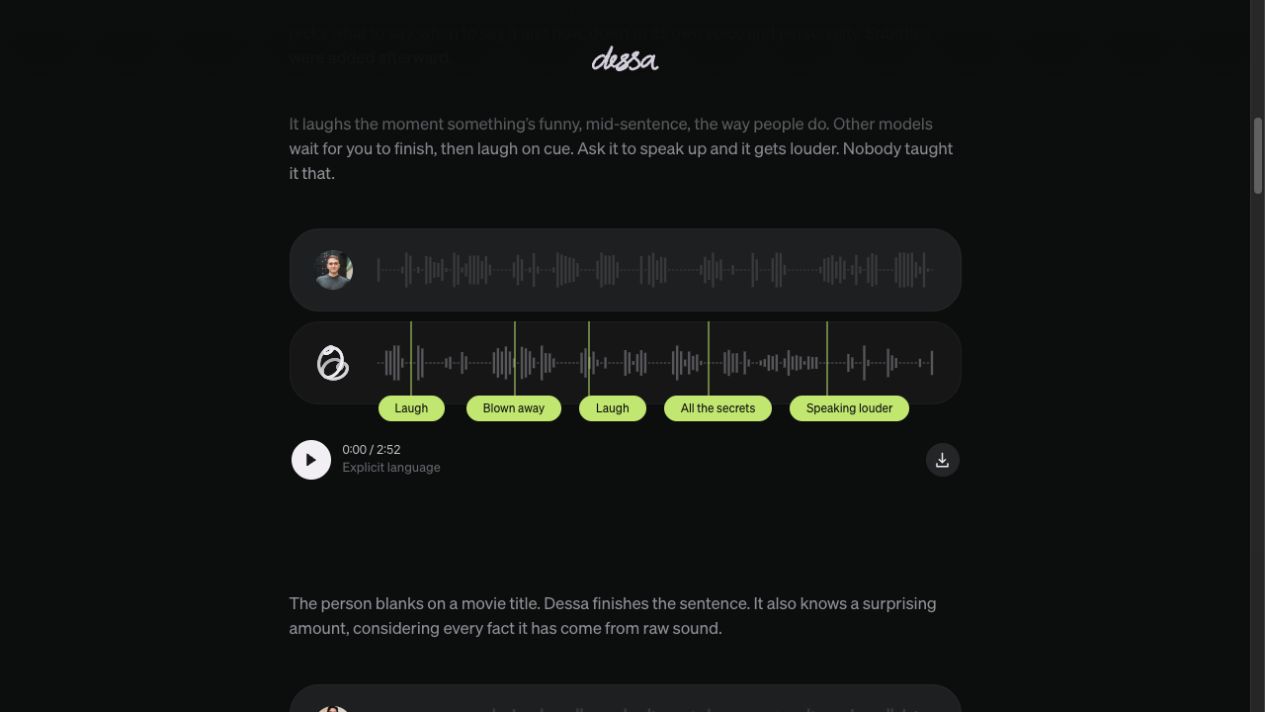
2026 年 10 月 28 日の公式ページ。実際の操作に合わせ、画面内の英語表記はそのまま示しています。
2 再生を始める
トラックの下にある三角形のボタンを押すと再生が始まります。再生中は同じ位置が一時停止ボタンになります。
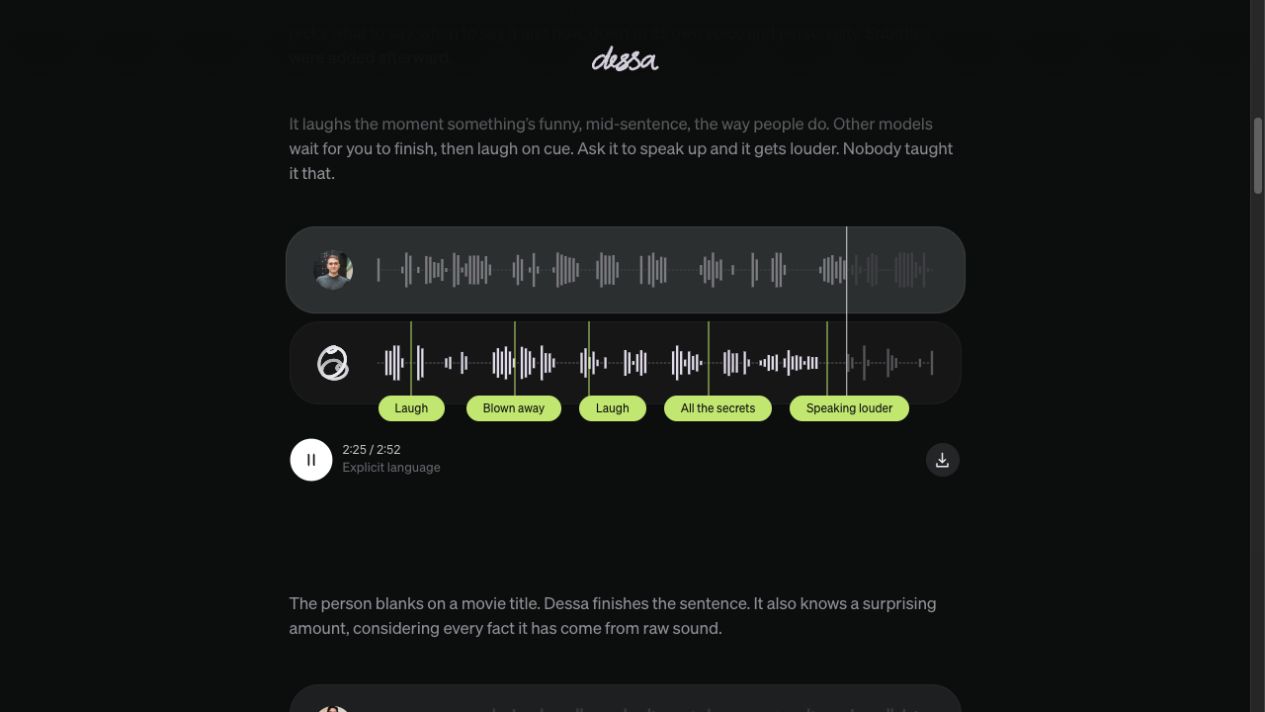
再生状態の例です。字幕は自動文字起こしのため、内容を追う補助として使います。
3 目的の場面へ移動する
緑色の Speaking louder を押すと、約 02:19 の声量を上げる場面に移動します。Laugh のマーカーからは笑いの場面を選べます。
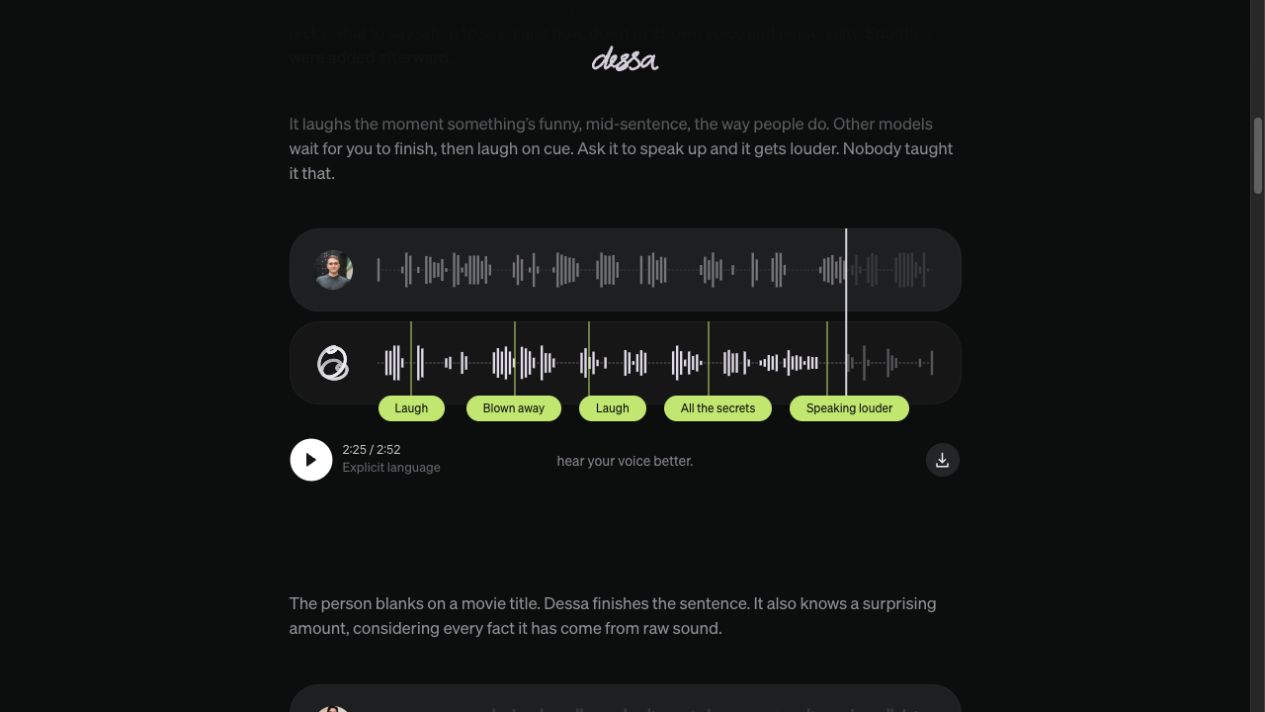
移動後の一時停止画面です。横のダウンロード操作はデモクリップ用であり、モデルの重みを取得するものではありません。
目的を決めて聴くと、どの振る舞いに注目すればよいかが分かります。
| 確認したいこと | 公式録音 | 公式の時間表示 |
|---|---|---|
| 笑いと、声量を上げる依頼への反応 | Talking about the release | 00:11–00:12、02:19–02:35 |
| 相手が思い出せないときの会話への参加 | Remembering a movie | 00:29–00:56 |
| 驚いたときの息づかいや小さな声 | An anniversary surprise | 00:47–00:48、01:01–01:05 |
時間は公式ページの注記に基づきます。Block は、人とモデルが会話した際の録音で、字幕は後から付けたと説明しています。ただし、開発元が選んだ例であり、さまざまな話題で同じ品質が出る割合を示すものではありません。録音の説明
想定用途を四つに分けて考える
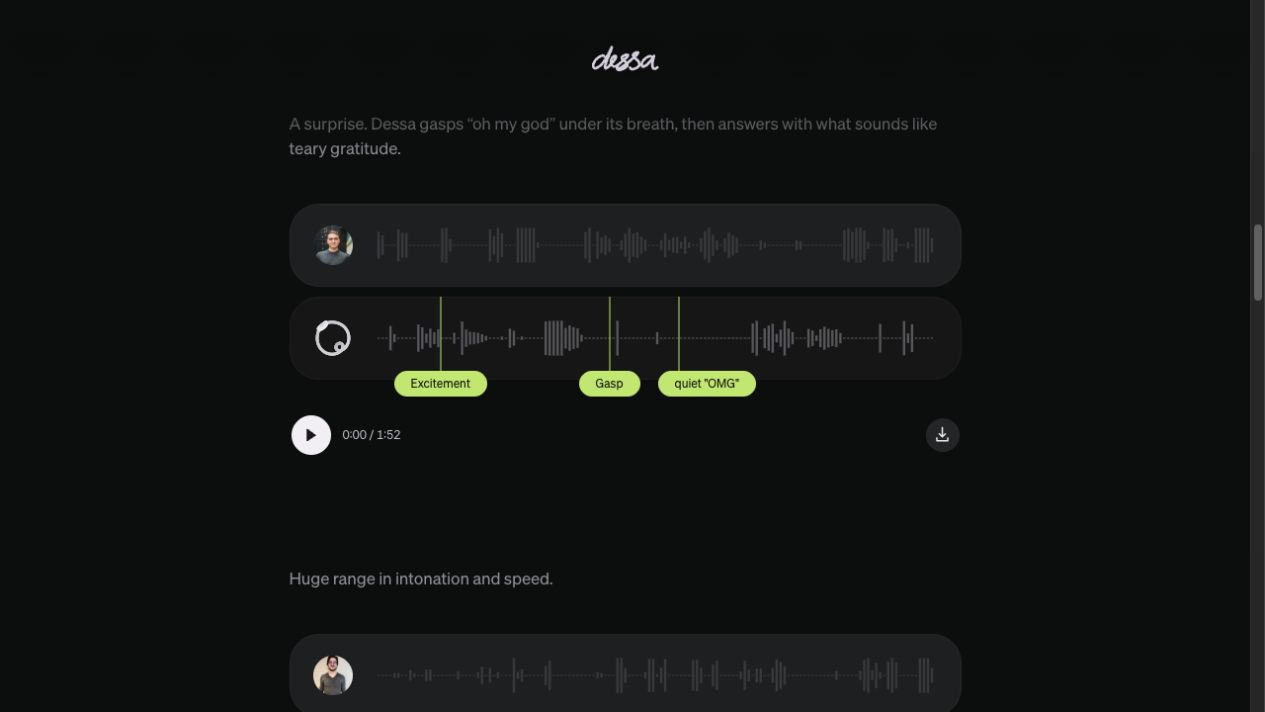
特定の状況で声がどう変わるかを観察する例です。公開済みのロールプレイアプリを示す画面ではありません。元のデモ
ここからは、デモの振る舞いから考えられる将来の用途です。紹介する話しかけ方は会話の設計例で、本稿で実行した指示ではありません。現在の公式ページに入力できるものでもなく、モデル公開後の確認が必要です。
日常の会話や音声での交流
一日の出来事を話すときは、長い助言よりも短い相づちや具体的な質問がほしいことがあります。そのような場面では、声の自然さに加えて、待つ時間や返答の長さも大切になります。Expressive conversation と Life advice は、その表現を見るためのサンプルです。
将来試すなら、「I finally finished the presentation I was worried about. Let me tell you what happened.」のように具体的な出来事から始めると、話題を共有しやすくなります。「心配していたプレゼンが終わったので、そのときのことを話したい」という意味です。
r/aipartners でも、自然な音声で会話できる相手への期待が語られています。これは利用者が望む用途の例であり、長期記憶や継続的な関係を維持する機能の証明ではありません。コミュニティの投稿
英会話や話す練習
英会話では、単語を思い出せないときに言い換えたり、相手の反応を受けて説明を足したりします。全二重の対話は、こうした練習を日常のやり取りに近づける可能性があります。
例えば「週末の出来事を二分で説明する」という課題を設け、「I'd like to practice talking about my weekend. Ask me one question at a time, and give me a moment to answer.」と伝える構成が考えられます。一度に一問ずつ尋ねてもらい、答える時間を取る設計です。
映画を思い出す録音では、会話の途中でモデルがどう参加するかを観察できます。ただし、発音の採点、文法訂正、教材機能が提供されているとは確認できません。対応言語の一覧も未公表のため、日本語を含む多言語の学習サービスとして紹介する段階ではありません。
物語の役や場面別の会話練習
物語の登場人物や接客の相手役には、直前の発言に合わせて返事を変える必要があります。記念日の録音は、状況に応じた声の表現を考える材料になります。
会話の設計例は「Let's role-play a conversation in a bookshop. You're the bookseller, and I'm looking for a mystery novel.」です。書店員と、ミステリー小説を探している客という役割と目的を決めます。
単に「人間らしく話して」と頼むより、練習する場面が明確です。ただし、Dessa がその役割指示を安定して守れるか、長い対話で設定を維持できるかは未検証です。ゲーム用プラグインやキャラクター編集機能が発表されたわけではありません。
音声アシスタントや店舗の応対
予約の途中で「金曜日……ではなく土曜日の夜」と言い直したとき、相手がその変更についてこられることには実用的な価値があります。全二重は、そのやり取りの改善につながる可能性があります。
一方、予約を確定する、注文を書き換えるといった処理には、業務システムとの接続が必要です。Hacker News にも、音声以外のデジタル情報とどう連携するのかという疑問が出ています。コメント中の案は公式の提供機能ではなく、現在は顧客対応・カレンダー・注文システムへ接続するための公開 Dessa API 文書はありません。連携に関する議論
試す前に公開範囲を確認する
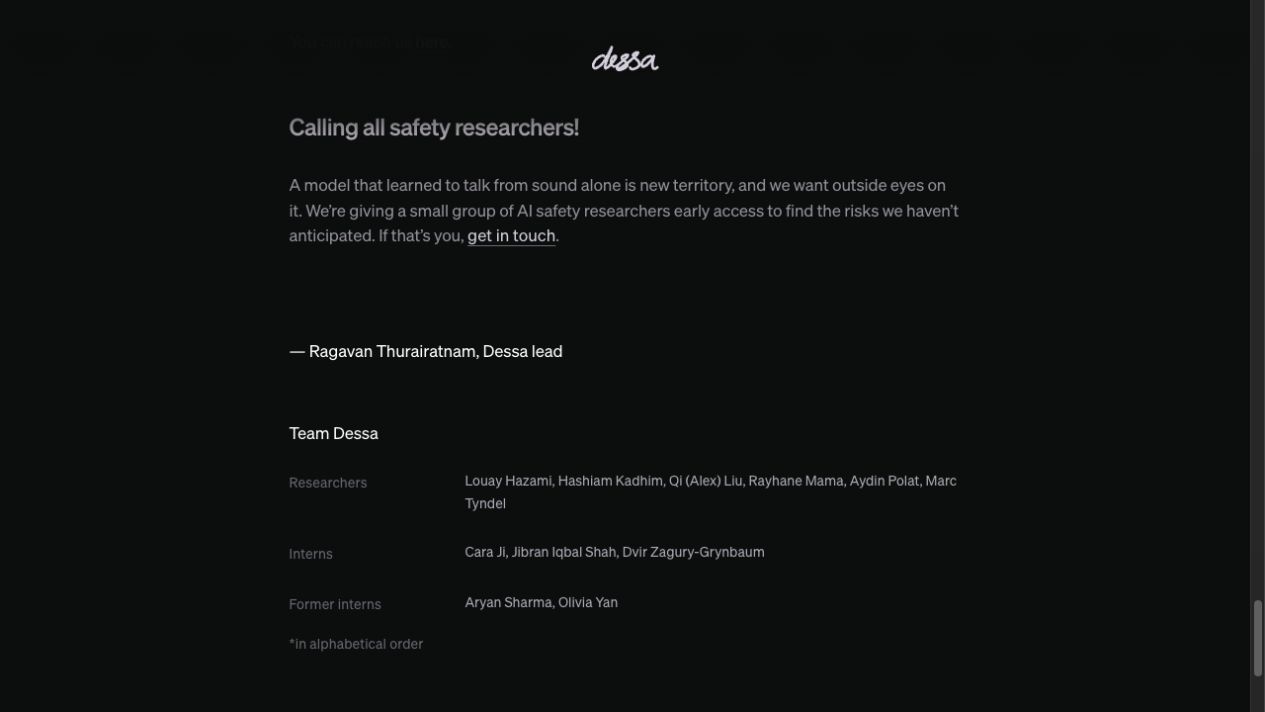
安全性研究者は公式ページ末尾の get in touch から連絡・申請方法を確認できます。一般向けの即時登録ではありません。公式案内
目的別の確認結果は次のとおりです。いずれも 2026 年 10 月 28 日の公開ページについての記述で、非公開の研究契約まで把握したものではありません。
| やりたいこと | 現在確認できる範囲 |
|---|---|
| 声や会話の間を聴く | 録音の再生と場面への移動が可能 |
| マイクで自由に話しかける | 一般公開の入口は未確認 |
| 動画やポッドキャストの原稿を読み上げる | 利用者向け TTS スタジオと商用条件は未公表 |
| 自分の声を複製する | 音声のアップロード・クローン手順は未公表 |
| 中国語で話す、日本語を練習する | 完全な対応言語一覧は未公表 |
| 既存のアシスタントの声を置き換える | 公開 API と接続方法は未公表 |
| パソコンに入れて動かす | 利用できるモデル配布と導入手順は未確認 |
提供状況を確認するときは、Block の公式ページが案内するリンクを起点にしてください。同じ名前を使う外部サイトが、このモデルを採用しているとは限りません。
全二重と音声だけの学習は別の特徴
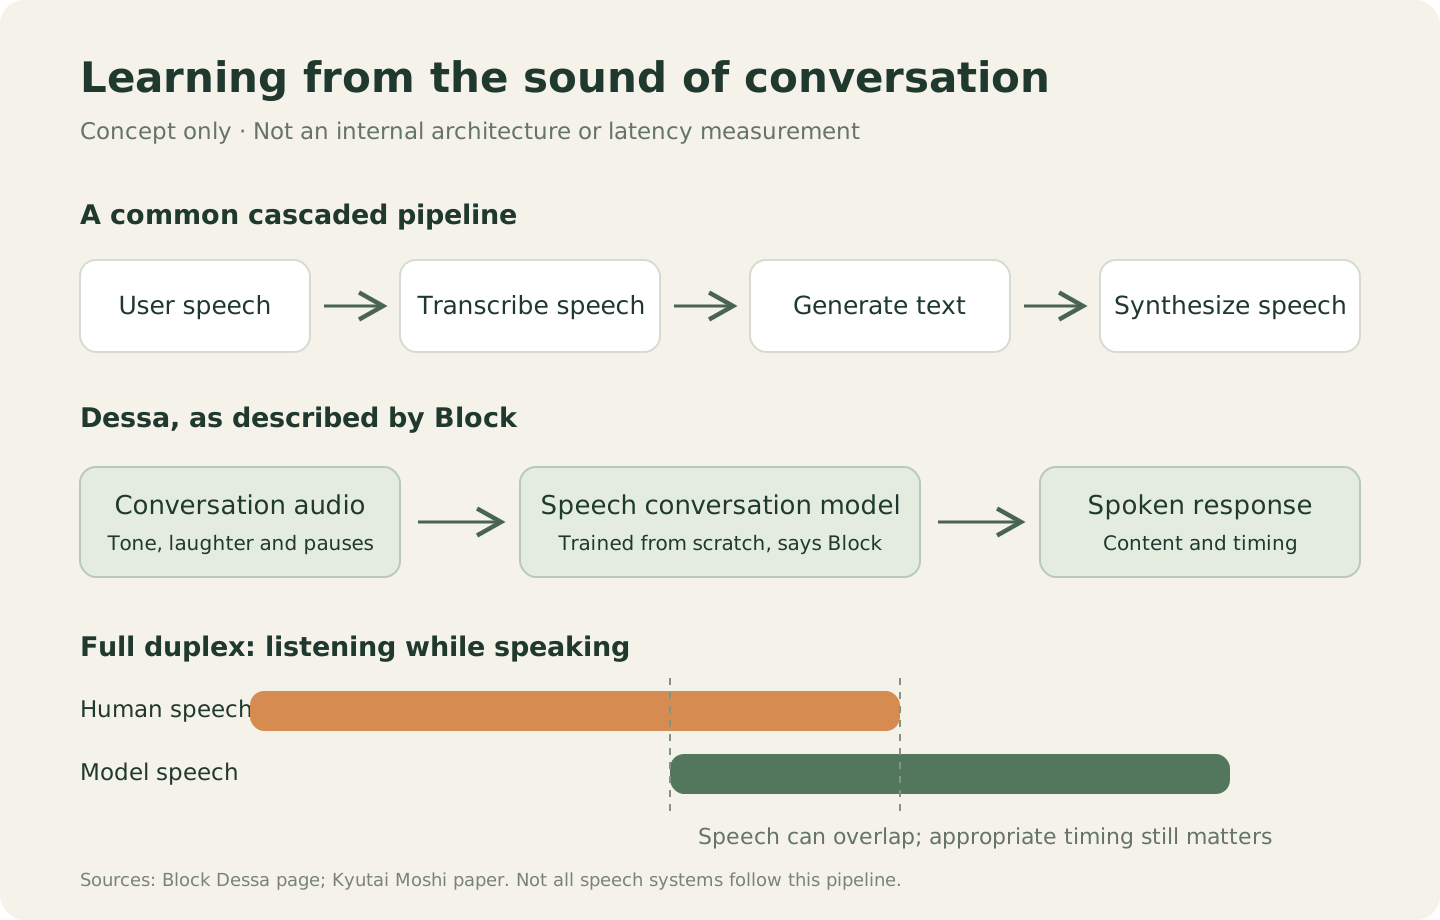
三言語で共用する英語ラベルの説明図です。内部ネットワークや遅延の測定値を示すものではありません。Block と Moshi 論文を参考に作成。
Block は、人の会話音声だけを使い、テキストも事前学習済みモデルも用いずにゼロから学習したと説明しています。これは開発元の技術的な主張です。一方の全二重は、発話しながら相手を聴けるという対話の方式を指します。公式説明
音声を文字にし、文章の回答を作ってから読み上げる構成では、ため息や語尾、笑いを含む否定のニュアンスを通常の文字起こしだけで十分に残せないことがあります。その情報と発話のタイミングを扱う点に、音声対話研究の意味があります。
全二重の研究そのものは Dessa より前にもあります。Moshi や Hertz-dev が先行例です。「同時に聞いて話せる世界初の AI」と一般化せず、Dessa が主張する学習方法と、実際に聴ける振る舞いを分けて読む必要があります。
コミュニティで評価が分かれる理由
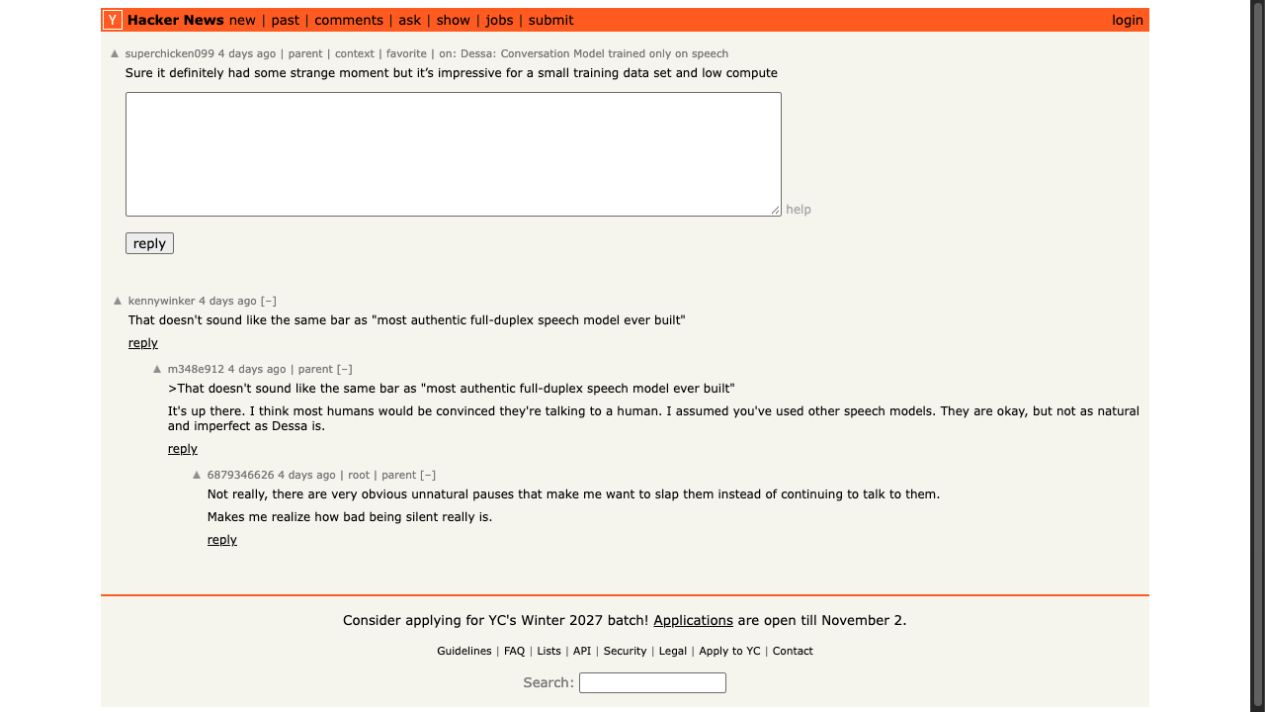
一つの議論に見られる感想の違いです。利用者全体を代表する調査ではありません。元の議論
r/OpenAI の tousledmonkey は息子の名前を口にするときの誇らしさに、lastbeer は文のつながりと抑揚に注目しました。対して r/accelerate の dichtbringer は、方向性を評価しつつも、一部の間が長く笑い声が大きすぎると感じています。声の細部への反応、別の聴き方。
雑談では関心を示す相づちでも、学習中は考えを遮り、業務の電話では要件を伝えにくくすることがあります。音色の好みだけでなく、目的に合う話す順序かどうかが問題になります。現段階のコメントは主にデモへの感想であり、導入後の運用報告ではありません。
ローカル実行の説明と導入可能性
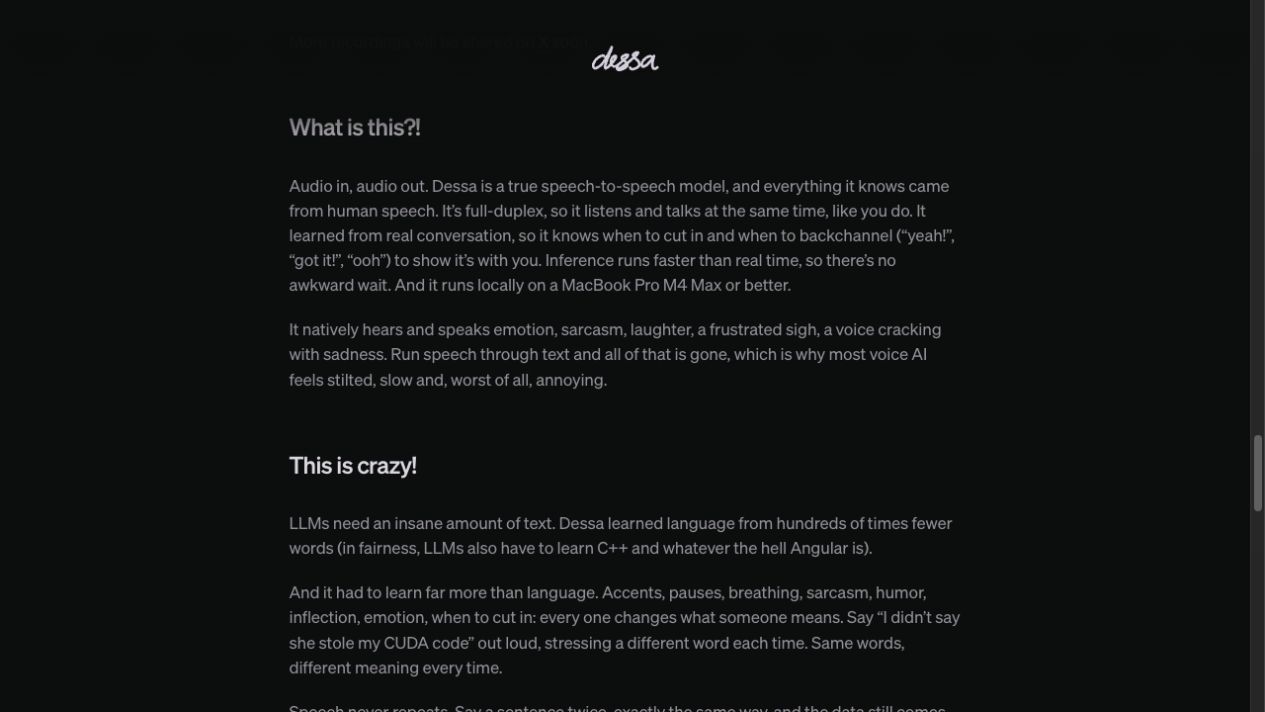
開発元が示した実行環境であり、インストール手順ではありません。出典
公式には MacBook Pro M4 Max 以上でローカル実行できるとされています。しかし、完全なメモリ要件、ソフトウェア環境、配布ファイルはまだそろっていません。Windows、Linux、ほかの GPU への対応も文書で確認する必要があります。
学習に使った機材と、完成したモデルを動かす機材も分けてください。チームが示す GB200 NVL72 はラック規模のシステムで、NVIDIA の仕様では Grace CPU 36 基と Blackwell GPU 72 基を接続します。「一台」を「GPU 一枚」と読み替えるのは誤りです。また、リアルタイムより速い推論という説明だけでは、利用者の発話から返答までの遅延は分かりません。Block、NVIDIA の仕様。
いま行えるのは、自分の目的に近い録音を選んで聴くことです。ナレーション制作、日本語学習、業務連携に使う計画は、対応機能・インターフェース・利用条件が公開されてから具体化できます。
参考資料
最新の記事
Vibe Coding Tools チームによる比較・レビュー・ワークフローの最新インサイト。
エディタ、ターミナル、モデル設定、クラウド開発に分けて AI ツールを比較。公式資料と Next.js で試せる評価手順を紹介します。
Airtapのクラウド端末でMuseに登録した操作記録。メール認証の期限切れ、生年月日の初期値、Metaアカウント作成、招待コードとチャットの確認範囲を解説します。