Jevモデル調査:AIワークフローで型付き判断を使う方法
Jevモデル調査:AIワークフローで型付き判断を使う方法
Jevは会話用の小型LLMとして理解するより、既存のLLMの横に置く判断レイヤーとして見る方が分かりやすいモデルです。アプリケーションが状態と質問を送り、Jevが選択肢、スコア、真偽値と確率を返します。アプリ側はその結果を使って、再試行、ユーザーへの確認、人手への引き継ぎなどの分岐を実行します。
ただし、候補と質問は開発者が決めます。正しい候補が用意されていなければ、確率が高くても正しい判断にはなりません。以下では、導入前に確認すべき順番をまとめます。
調査日:2026年9月21日。価格、利用可能なチーム、SDKの仕様は更新されるため、実装時には各公式ページを再確認してください。
1. まず出力契約を確認する
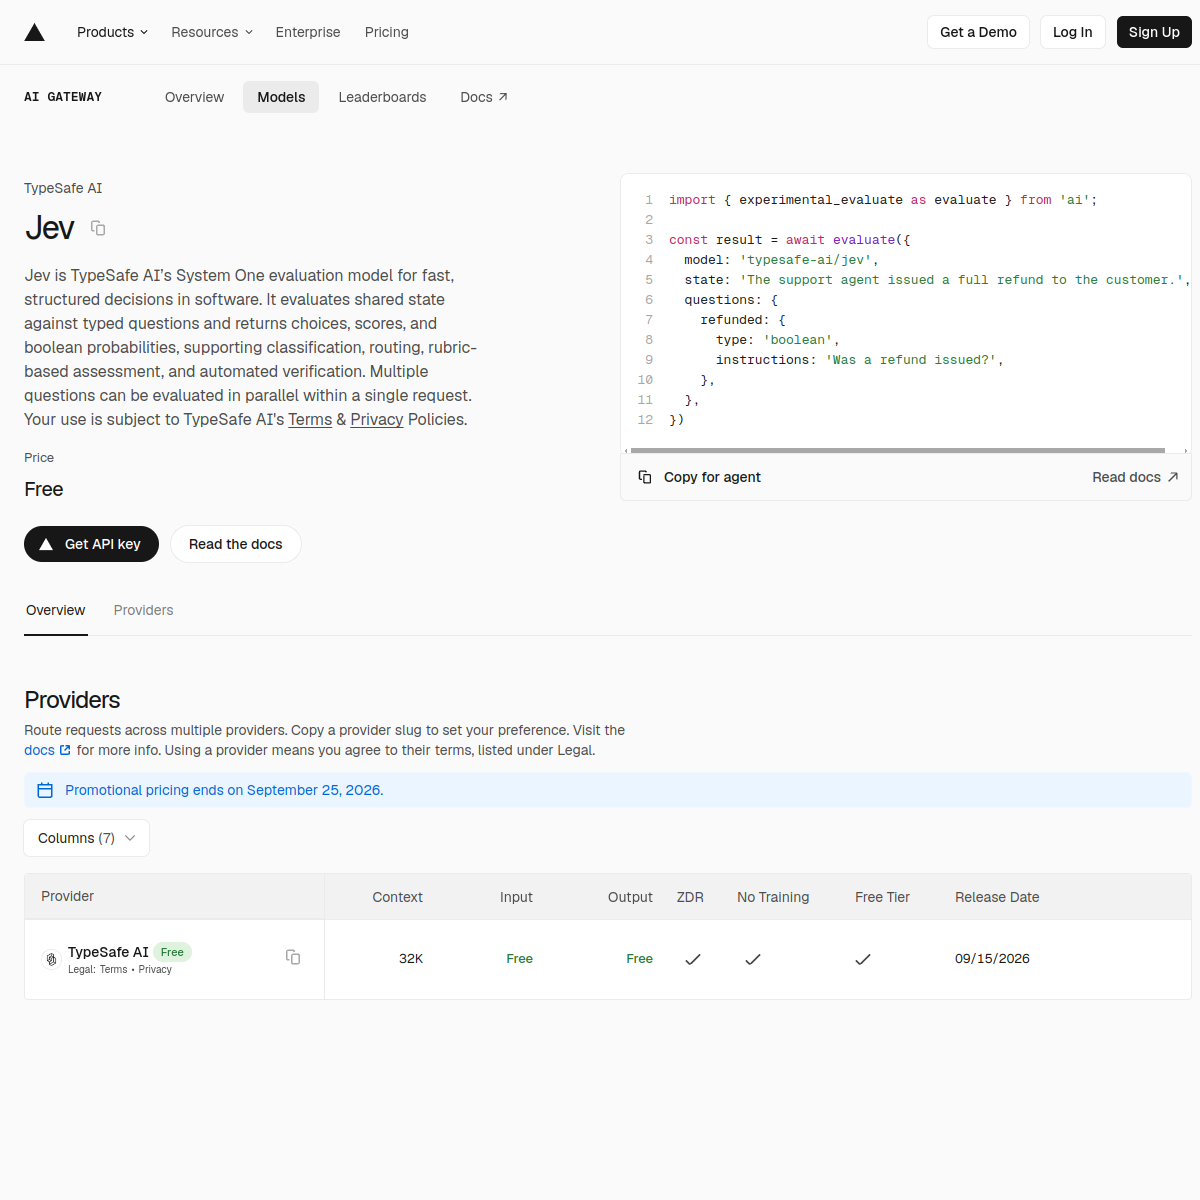
VercelのJevページでは、JevをTypeSafe AIのSystem One評価モデルとして説明しています。共有stateを型付きの質問に照らし、choice、score、booleanの確率を返します。複数の質問を1リクエスト内で並列評価できる点も、通常のテキスト生成とは違います。
| 確認項目 | Jev | 汎用LLM |
|---|---|---|
| 主な出力 | 候補、スコア、真偽値、確率 | テキストまたは構造化テキスト |
| 向く処理 | 分類、ルーティング、検証、ルーブリック | 文章、コード、説明、自由回答 |
| アプリへの接続 | 結果をそのまま分岐に使いやすい | JSON検証や再試行を追加する場合がある |
| 注意点 | 候補設計が結果の上限を決める | 形式を守っても内容が正しいとは限らない |
Jevは文章やコードを作るモデルではありません。出力を次のアクションに変換するところが価値です。
2. stateは毎回アプリから渡す
JevにChatGPTのような自動会話記憶があると考えると、設計を誤ります。各API呼び出しにはstateとquestionsを渡します。前回の画面、実行した操作、結果、残っている目標が次の判断に必要なら、アプリが履歴を要約して新しいstateへ含めます。TypeSafeのstateドキュメントとAPIドキュメントで現在の入力形式を確認してください。
この制約は欠点であると同時に、状態管理の責任範囲を明確にします。サービス側の暗黙の記憶に依存せず、どの履歴を判断へ渡したかをアプリ側で監査できます。
3. 適用範囲は「分岐が決まっている処理」
次のような場面なら、Jevを検証する理由があります。
- 次に呼ぶAgentやツールを選ぶ
- ワークフローを続行、再試行、確認、停止のどれにするか決める
- チケットの緊急度やリスクを段階評価する
- 別のモデルの出力を検査し、低確信度なら人へ送る
- 固定した評価基準で候補や問い合わせを分類する
高い確率は正解率ではありません。候補に「該当なし」や「要確認」を含めるべき業務では、その選択肢を設計段階で用意します。TypeSafeの性能比較もベンダー側の評価なので、実際のstate長、並列数、再試行方針で測り直します。
Vercelは、公開後24時間で有料AI Gatewayチームの約13%がJevを使用したと報告しています。これはVercelの匿名化されたプラットフォーム内の観測であり、開発者市場全体の普及率ではありません。Vercelの発表
4. 利用条件と料金を現在のページで確認する
調査時点のVercel Jevページには、モデル価格がFreeと表示され、API keyの入口とチームの利用可否を確認する表示があります。プロモーション価格の終了日は2026年9月25日です。チームの権限、クォータ、プロバイダーの条件はコンソールの表示を優先します。
Jevの重みをTypeSafeが公開しているわけではないため、オフラインで実行する手順はありません。公式JavaScript SDKのREADMEには @typesafe-ai/sdk、TypeSafeClient、systemOne の例があります。Vercel側にはAI SDKの experimental_evaluate 例があります。どちらも実装前に現在のバージョンとレスポンス形式を固定してテストします。
5. 最小のJavaScript例を先に動かす
Vercelの例を簡略化すると、状態と質問を送り、booleanの結果をアプリ側で利用します。
import { experimental_evaluate as evaluate } from "ai";

const result = await evaluate({
  model: "typesafe-ai/jev",
  state: "The support agent issued a full refund to the customer.",
  questions: {
    refunded: {
      type: "boolean",
      instructions: "Was a refund issued?",
    },
  },
});

console.log(result);
このコードをそのまま本番へ入れるのではなく、API key、プロバイダーの可用性、出力フィールド、無料枠、失敗時の分岐を確認します。LLMの回答文を解析する処理を減らせても、候補設計と評価データは必要です。
6. オープンソース代替案をJevと混同しない
調査した公式情報の範囲では、TypeSafeがJevの重みを公開したとは確認できません。次のプロジェクトは、似たインターフェースや研究方向を持つ独立実装です。
| プロジェクト | 内容 | 境界線 |
|---|---|---|
| OpenJev | Qwen3-4B-Instruct-2507を使うローカル研究プレビュー | TypeSafeと無関係で、Jevとの同等性を主張していない |
| Mapika/decider | Qwen3.5-2BベースのSystem One風実装 | 学習データと品質は別途評価が必要 |
| von | ローカル非自己回帰の意思決定モデル | リポジトリの速度主張はJevとの比較結果ではない |
ローカルでインターフェースを試すならOpenJev、モデル構造や校正を研究するなら他の2つが候補になります。「Jevのオープンソース版」と呼ぶ前に、重み、学習方法、同一データでの比較結果を確認してください。
導入前の判定表
| 項目 | 合格条件 |
|---|---|
| 判断範囲 | 候補と「要確認」を定義できる |
| 状態 | 必要な履歴をアプリが明示的に保存して渡せる |
| 評価 | 正解率、確率の校正、遅延、コストを実データで測れる |
| 失敗処理 | 低確信度や候補外を人へ送れる |
| 仕様 | 可用性、API、価格、規約を現在のコンソールで確認できる |
この条件を満たすとき、Jevは生成モデルの代用品ではなく、AIワークフローの分岐を明示する部品として検証できます。
参考資料
最新の記事
Vibe Coding Tools チームによる比較・レビュー・ワークフローの最新インサイト。
検索キーワードと公開ページを手がかりに、Pollo・Invideo・Artlistの導線を比較。第三者ブランドの検索意図、選び方、制約の伝え方を整理します。
Similarweb、Google Trends、競合ページの流入と KGR の計算例を使い、音声字幕ツールを作る価値があるか調べます。
Taste Skillのインストール方法と使い方を、実際のページ画像やコピーして使えるプロンプトで紹介。用途別スキルとコミュニティの評価、公式リンクも掲載。