Xiaomi-OCR-0:小米如何把 Qwen 训练成 0.8B 文档专才
想把扫描件、表格或带公式的论文变成可编辑内容,可以看看 Xiaomi-OCR-0。这是小米推出的 0.8B 参数视觉语言模型,既能解析文档,也能从图中提取字段、回答问题。
它的起点是 Qwen3.5-0.8B-Base,训练语料约 1.7 亿条(170M)样本。理解它最简单的办法,是把整个过程看作“培养一位专门处理文件的实习生”:先准备教材,再教他定位文字,随后全面训练,最后用难题考核。官方模型卡给出了这套路线和下面的成绩。
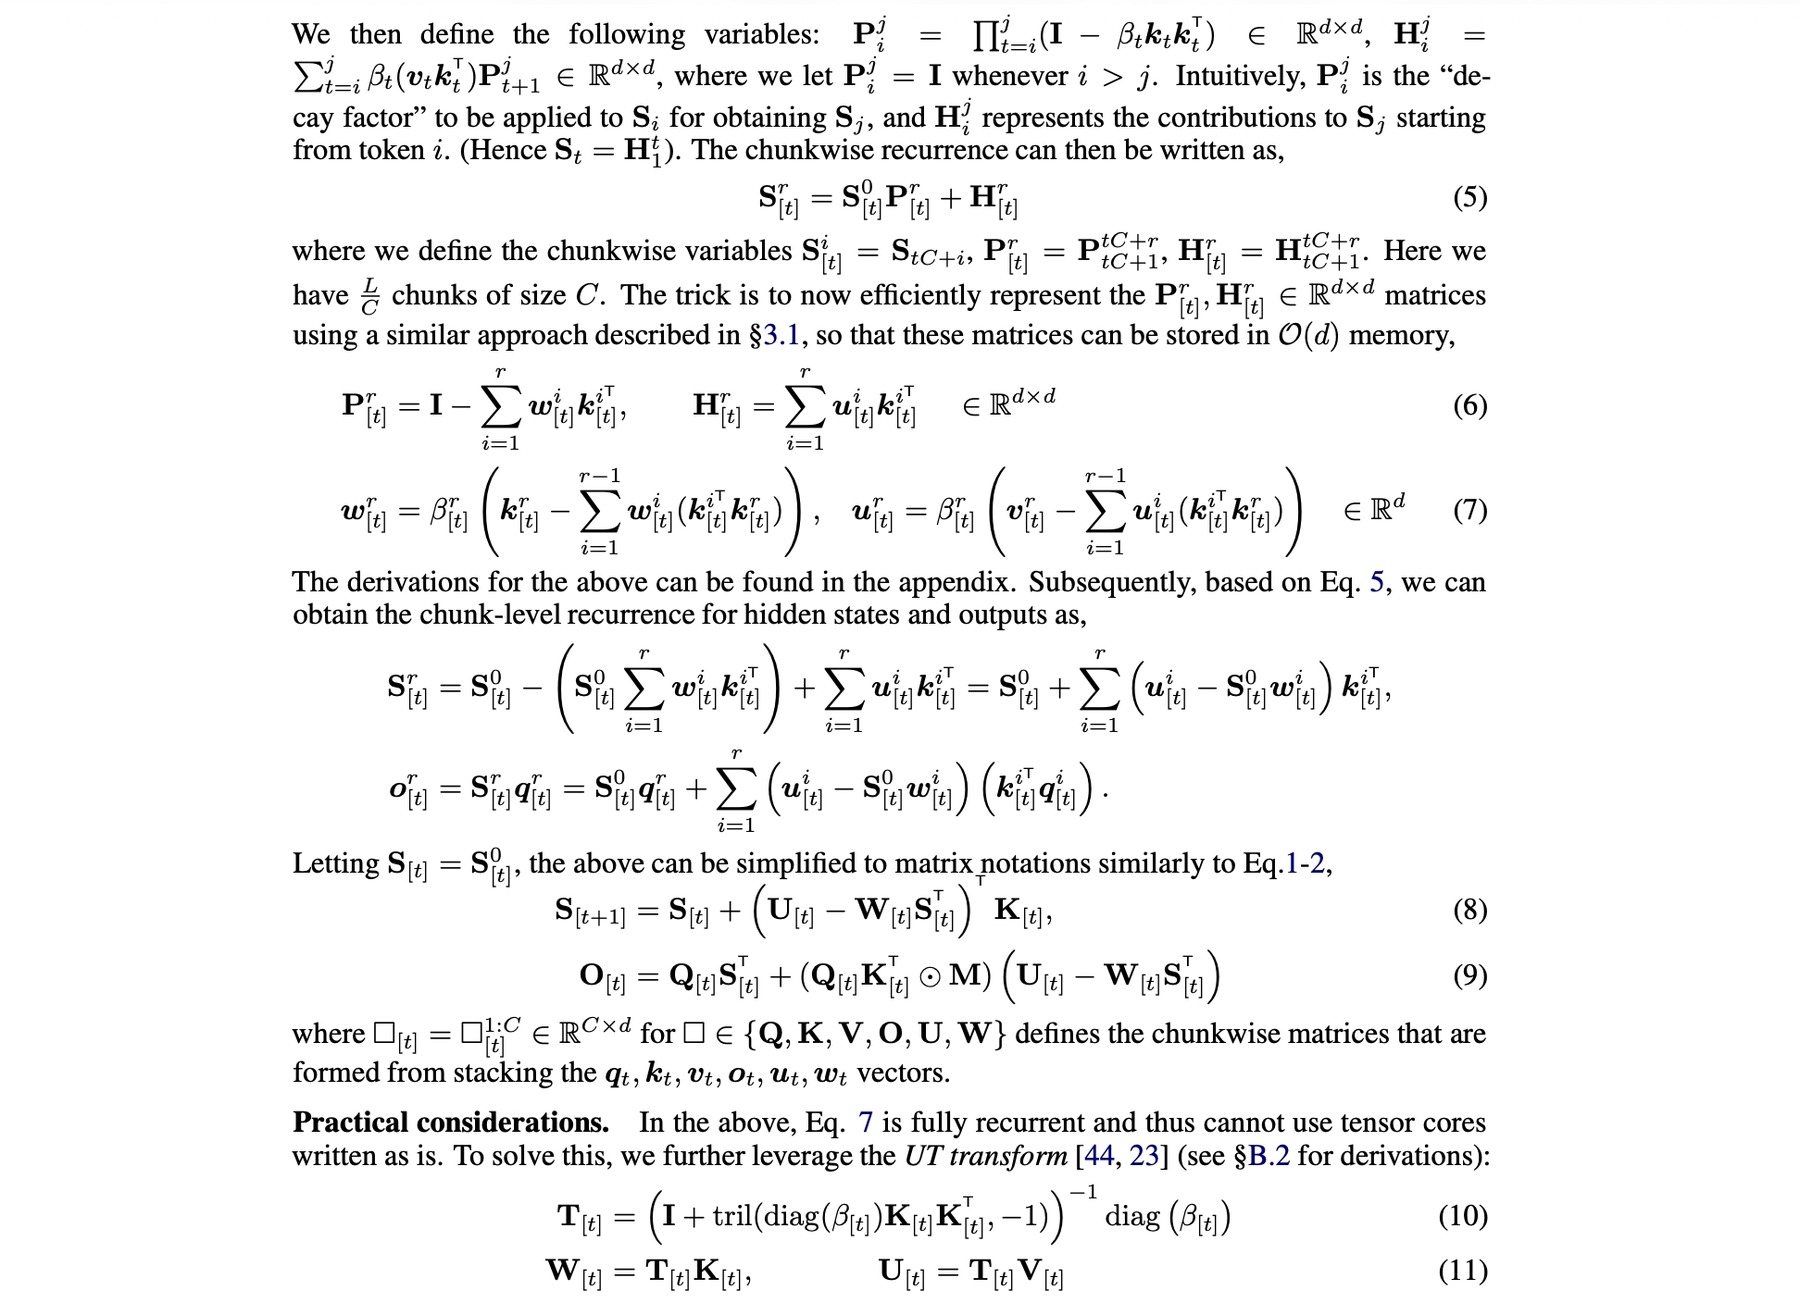
图片来源:官方 example_pics/dense-equations.jpg。这是一张输入示例,也是本文三语共用封面。
它能处理哪些文件任务?
| 任务 | 你给它什么 | 希望得到什么 |
|---|---|---|
| 文档解析 | 一页论文、扫描件或拍照文档 | 按阅读顺序组织的内容,包含文本、表格和公式 |
| KIE:关键信息抽取 | 一张文档图片和需要的字段 | 结构化字段,例如按指定 JSON 格式输出 |
| OCR-VQA:围绕文字的视觉问答 | 文档图片和一个问题 | 根据图片内容回答问题 |
模型卡强调了扫描、扭曲、拍照、倾斜等文档的处理能力,也列出了历史手写与书法成绩。可以把它理解为一个小型文档助手:抄内容、找字段、答问题,共用一个模型。
整页解析和区域模式要分开看。官方 Transformers 示例直接处理整页图片;Ollama 指南还提供区域模式,后者需要额外的 layout 依赖。
从 Qwen 训练出来,到底是什么意思?
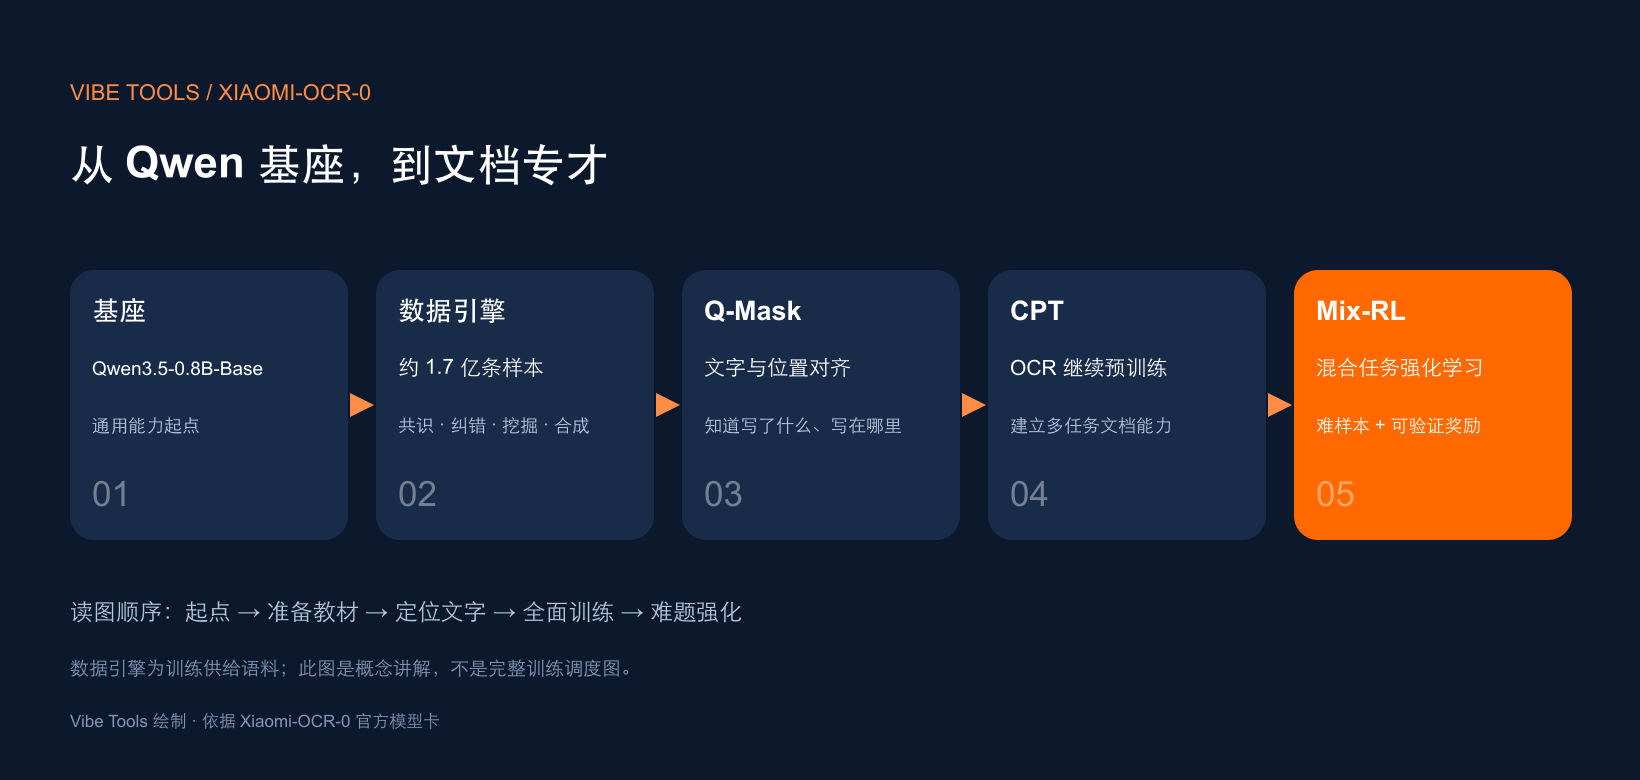
图由 Vibe Tools 根据官方模型卡绘制。箭头表示讲解顺序;数据引擎为训练提供语料。
1. 基座:招进来一位有通用能力的实习生
Qwen3.5-0.8B-Base 是训练起点。 小米在它已有能力的基础上继续训练,让参数更适合 OCR 和文档理解任务。
类比一下:你招到一位有通识基础的实习生,接下来要把他培养成能处理合同、论文和票据的人。这不等于说基座完全不会看文档,而是后续训练让它更专注、更熟练。
2. 数据引擎:给实习生准备可靠教材
约 170M 样本覆盖文档解析和围绕 OCR 的理解任务。难点不只是收集文件,还要给文本、表格、公式配上可靠答案。
官方的数据引擎可以拆成四个容易理解的动作:
- 找多位老师批改。 异构专家池生成候选标注;ETC(三方共识)按整个专家池的一致程度排序,选出三位专家达成共识的子集,再把不确定样本送去精炼。它比简单地让某一个模型充当唯一答案来源更稳妥。
- 把答案还原成图。 专家意见不一致时,把候选标注重新渲染成图片,与原图区域比较。表格行列错位、公式结构出错,便更容易被发现。
- 挑值得练的题。 结合专家一致度、模型自一致性、语义聚类和已验证的失败模式来筛样本。
- 缺什么就补什么。 覆盖驱动合成补齐结构、样式、字形、领域;失败驱动合成针对训练中反复出现的错误。
模型卡列出的专家包括 PaddleOCR-VL-1.6、MinerU2.5-Pro、GLM-OCR、dots.mocr、HunyuanOCR-1.5、TeleOCR、OvisOCR2 和 Qianfan-OCR。可以把这一步想成:老师共同出教材,争议题先检查,学生老错的题再单独加练。
3. Q-Mask:不仅认出字,还要知道字在哪里
Q-Mask 做的是细粒度文字与位置对齐。
实习生抄出了一个金额,还得能指出它在原件的哪个位置。否则,到了找字段、区分表格单元格时,就容易混淆。这个类比解释了“文本锚定”的目标;具体机制以官方报告为准。
4. CPT:先做全面的文档训练
CPT 是 Continued Pre-training,也就是继续预训练。官方把这个阶段用于建立广泛的 OCR 多任务能力。
这相当于让实习生轮岗:文本、表格、公式和文档问答都练到,先建立共同的基本功。
5. Mix-RL:用能核对答案的难题继续提高
Mix-RL 是混合任务强化学习。它在难样本上使用可验证奖励,继续提高模型能力。
类比就是轮岗后的实战考核:题更难,做完有可核对的反馈。CPT 提供基础,Mix-RL 再围绕难题改进。这也解释了为什么它们承担不同的作用。
成绩怎么看:小模型的解析很强,理解还有差距
下面是官方模型卡公布的主要结果,排名也采用该模型卡的表述。
| 基准 | Xiaomi-OCR-0 成绩 | 对应任务 |
|---|---|---|
| OmniDocBench v1.6 | 96.83,第 2 | 文档解析 |
| Wild-OmniDocBench | 87.94,第 2 | 复杂真实场景文档解析 |
| Real5-OmniDocBench | 95.24,第 1 | 文档解析 |
| UniMER-Test | 97.84 | 公式识别 |
| PubTabNet | 92.27 | 表格识别 |
| Chronicles-OCR Mature Scripts | 73 | 隶、草、行、楷等历史手写与书法;Seed 2.0 Pro 为 72 |
| 五项 OCR-VQA 平均 | 83.2 | DocVQA、InfoVQA、ChartQA、OCRBench、TextVQA |
和其他解析模型相比
| 模型 | 参数量 | OmniDocBench v1.6 ↑ | Real5 ↑ | Wild ↑ |
|---|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 96.83 | 95.24 | 87.94 |
| TeleOCR | 1.2B | 96.87 | — | 88.53 |
| OvisOCR2 | 0.8B | 96.58 | 92.29 | 87.91 |
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 93.19 | 87.36 |
| MinerU2.5-Pro | 1.2B | 95.75 | 88.94 | 87.33 |
| GLM-OCR | 0.9B | 95.22 | 90.32 | 85.08 |
↑ 表示越高越好;“—”表示来源未报告;加粗标出本文主角。
Qwen 基座经过专门训练后提升多少?
| 模型 | DocVQA | InfoVQA | ChartQA | OCRBench | TextVQA | 五项平均 |
|---|---|---|---|---|---|---|
| Qwen3.5-0.8B | 88.5 | 60.3 | 69.5 | 77.9 | 68.3 | 72.9 |
| Qwen3.5-2B | 92.4 | 72.4 | 77.0 | 85.9 | 76.9 | 80.9 |
| Xiaomi-OCR-0 | 93.1 | 75.1 | 84.6 | 84.6 | 78.6 | 83.2 |
五项平均采用 0–100 分制的算术平均。Xiaomi-OCR-0 的平均分高于 Qwen3.5-2B,但并非每一列都更高,例如 OCRBench 为 84.6,对方为 85.9。
CPT 和 Mix-RL 分别贡献了什么?
| 训练结果 | 解析 Overall(OmniDocBench v1.6) | 理解 Overall(五项 VQA 平均) |
|---|---|---|
| 0.8B CPT | 96.4739 | 78.1 |
| 0.8B MOPD | 96.7417 | 82.7 |
| 0.8B Mix-RL | 96.8277 | 83.2 |
| 4B 单任务教师 | 96.9745 | 88.1 |
从 CPT 到 Mix-RL,解析从 96.4739 提高到 96.8277,理解从 78.1 提高到 83.2。MOPD 是使用一个解析教师和一个理解教师的对比方案:它收敛快,较长训练的 Mix-RL 达到了更高峰值。
4B 教师与 0.8B 学生的差距在理解上约为 4.9 分,在解析上约为 0.15 分。这里两个教师各自专攻一个任务,学生同时训练两类任务;同一任务的数据量相同,不能把整个差距只归因于参数量。
还有一个实用发现:理解数据并非越早加入越好。 在分别使用 9%、29%、50% 解析数据的三个阶段,相对各阶段解析基线的变化依次是 −0.330、+0.639、+0.0749。先把解析基础练好,再加入理解训练,更符合官方这组实验的结果。
本地试用:先跑通一张图片
建议先选一张能人工核对的图片,检查文字、公式和阅读顺序,再处理整批文件。官方示例里有密集公式页面,也有下面这样的手写推导。
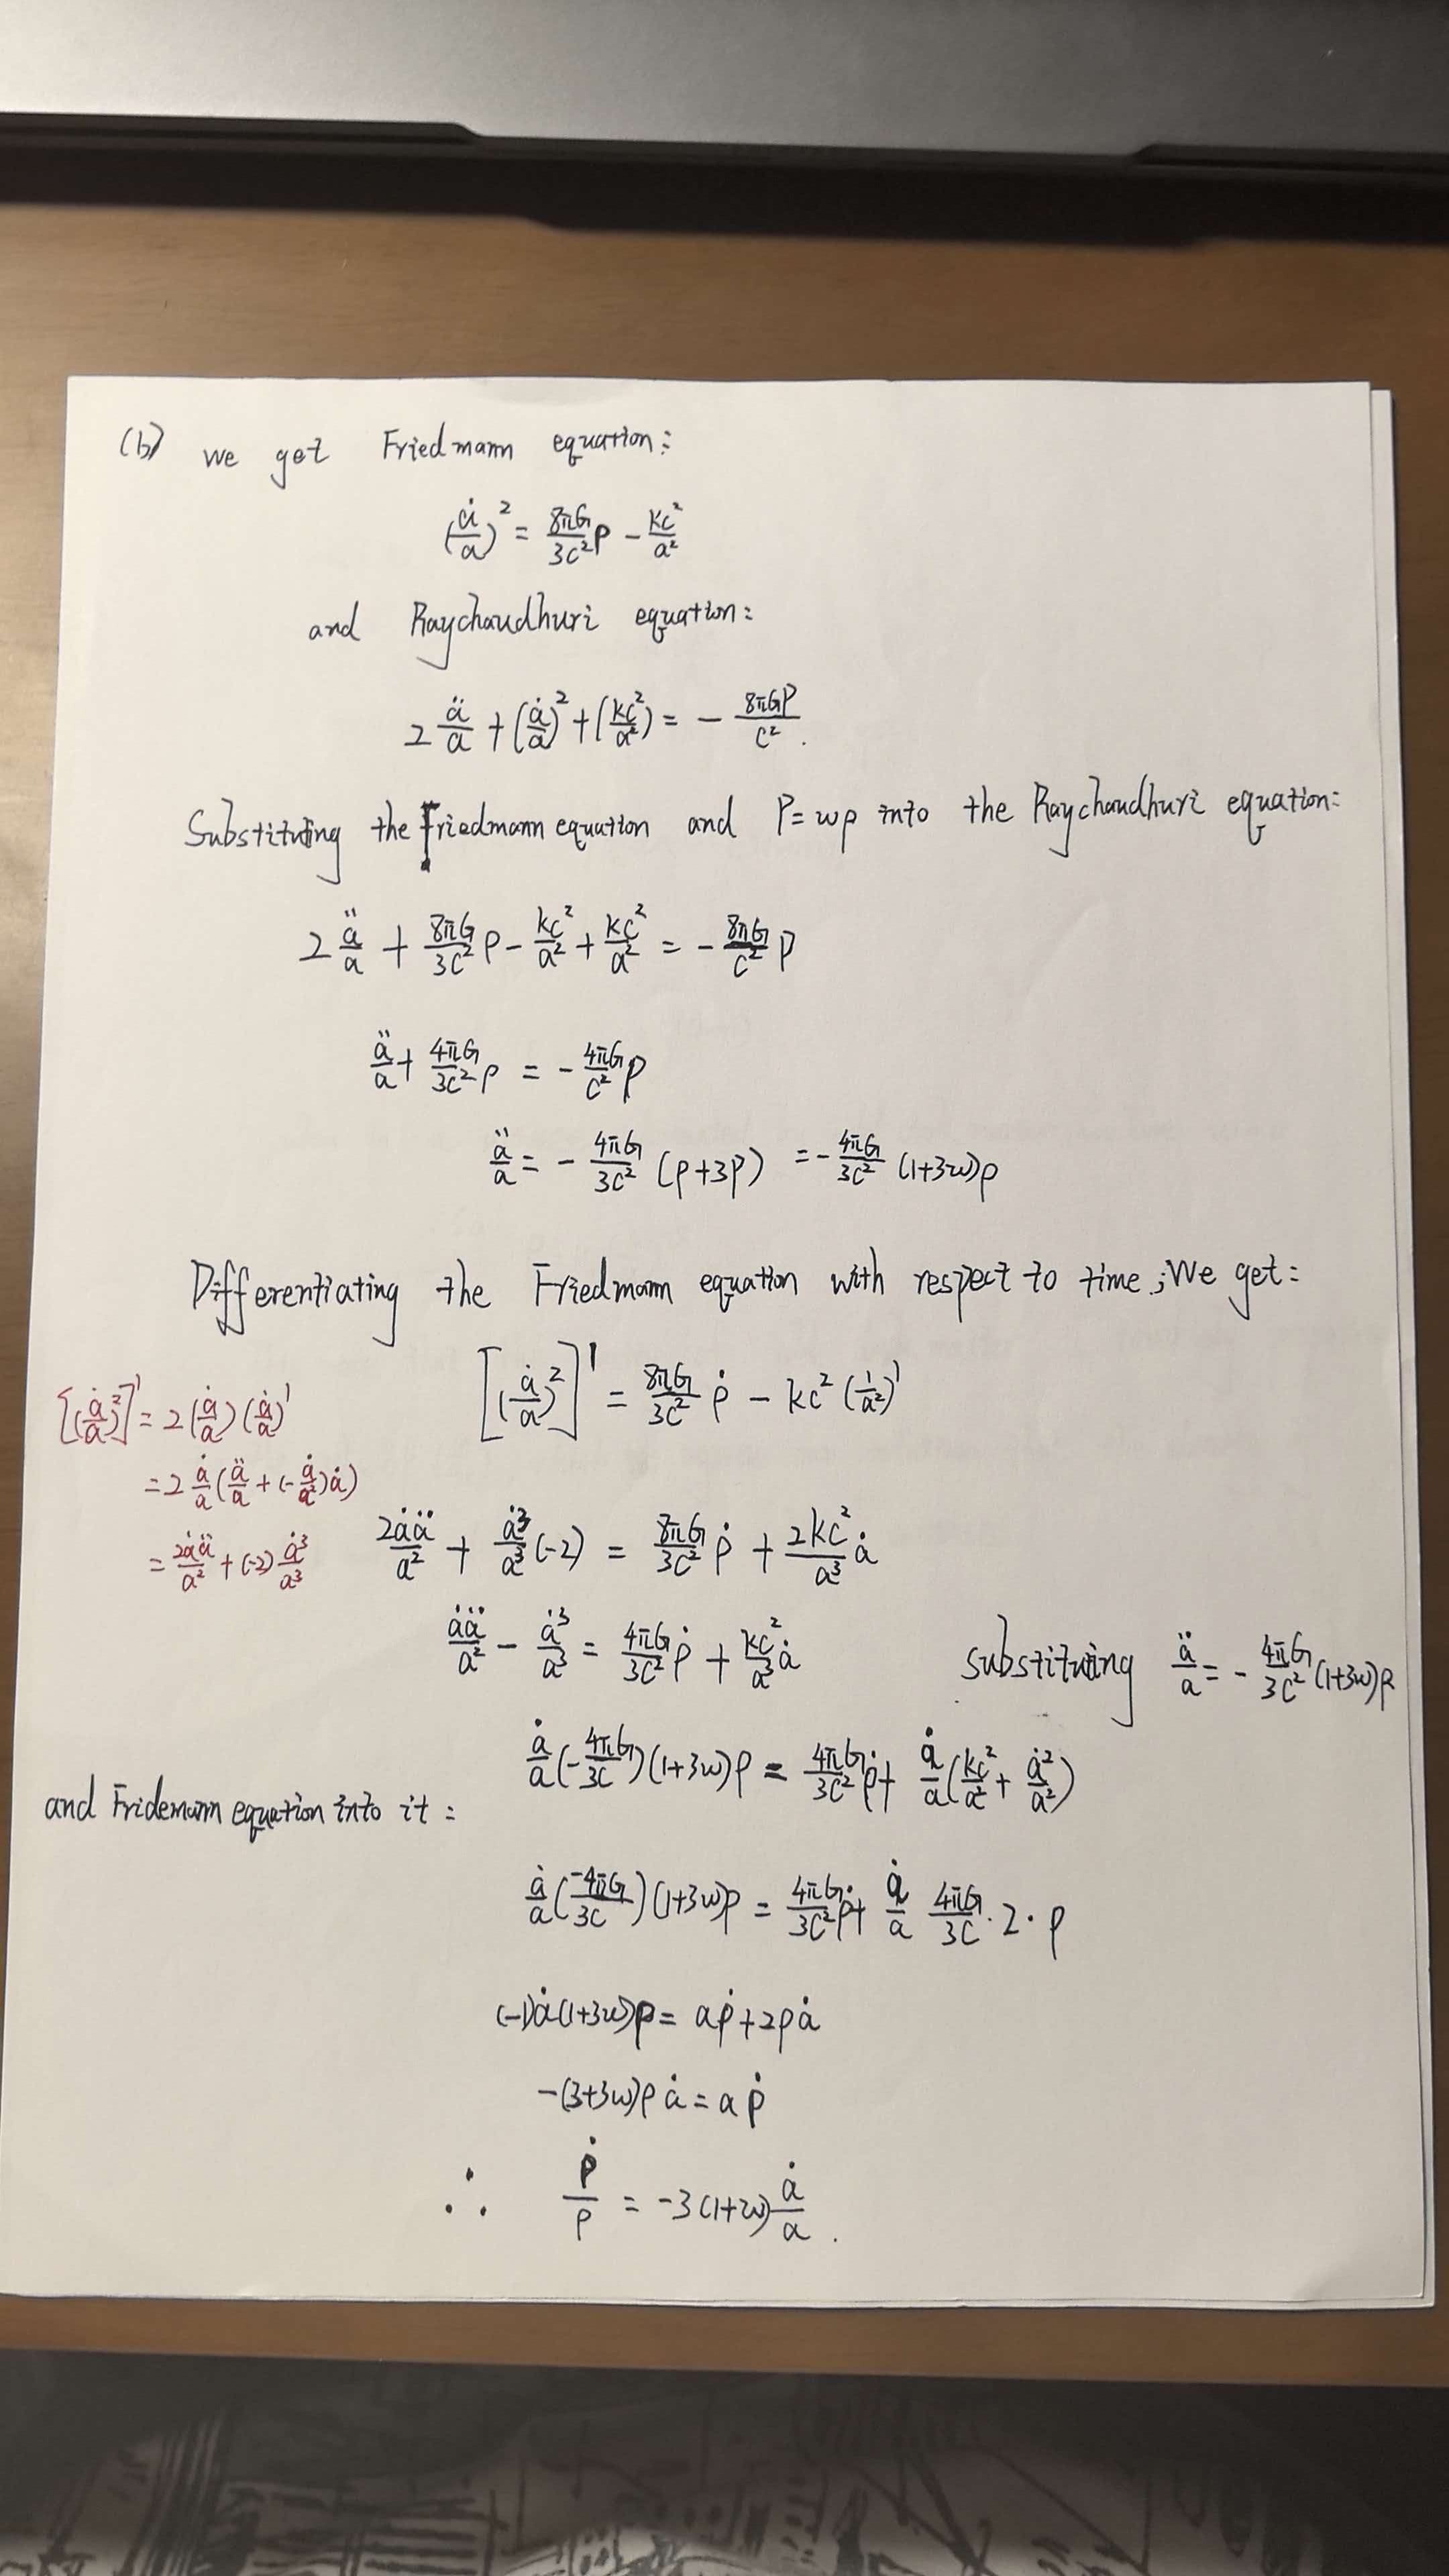
图片来源:官方 example_pics/handwrite-formula.jpg。它展示输入文件类型,输出示例可在模型卡中查看。
路线一:Ollama,配合仓库 MCP 或 Demo
官方将这条路线标为实验性。先安装并启动 Ollama,再拉取约 1.8 GB 的社区 BF16 包,里面包含文本模型和视觉投影器:
ollama pull longwayxu/xiaomi-ocr-0:bf16
接着按仓库 Ollama 指南配置 MCP 服务或浏览器 Demo。它们会自动应用图像预处理、非思考 prompt 和解码设置。只执行 pull 不会配置这些步骤。 指南还覆盖 PDF 解析、KIE、VQA;区域模式另需 layout 依赖。
路线二:Transformers,直接运行整页解析
下面采用模型卡给出的版本组合。先准备环境:
uv venv --python 3.13
source .venv/bin/activate   # Windows: .venv\Scripts\activate
uv pip install "transformers==5.17.0" "torch==2.14.0" "torchvision==0.29.0" pillow
把下面代码保存为 ocr_demo.py,然后执行 python ocr_demo.py。示例使用本文引用的官方仓库 ID,下载一张官方示例图片并解析;也可以将 IMAGE 换成本地图片路径。
import torch
from huggingface_hub import hf_hub_download
from transformers import AutoModelForImageTextToText, AutoProcessor

MODEL = "xiaomi-research/Xiaomi-OCR-0"
# Choose "qianziwen.jpeg" or "dense-equations.jpg".
IMAGE = hf_hub_download(
    repo_id=MODEL,
    filename="example_pics/qianziwen.jpeg",
)
PROMPT = (
    "Extract all information from the main body of the document image and represent it "
    "in markdown format, ignoring headers and footers. Tables should be expressed in OTSL "
    "format, formulas in the document should be represented using LATEX format, and the "
    "parsing should be organized according to the reading order."
)

device = (
    "cuda" if torch.cuda.is_available()
    else "mps" if torch.backends.mps.is_available()
    else "cpu"
)
dtype = torch.float32 if device == "cpu" else torch.float16
processor = AutoProcessor.from_pretrained(MODEL)
model = AutoModelForImageTextToText.from_pretrained(
    MODEL, dtype=dtype,
).to(device).eval()

messages = [{
    "role": "user",
    "content": [
        {"type": "image", "url": IMAGE},
        {"type": "text", "text": PROMPT},
    ],
}]
inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
)
inputs = inputs.to(device)

with torch.inference_mode():
    output = model.generate(**inputs, max_new_tokens=4096, do_sample=False)

new_tokens = output[:, inputs["input_ids"].shape[1]:]
print(processor.batch_decode(new_tokens, skip_special_tokens=True)[0])
输出按阅读顺序组织,公式使用 LaTeX,表格使用 OTSL。OTSL 是表格结构表示,不能直接当作普通 Markdown 表格来理解。遇到长文档输出被截断时,应留意示例的 max_new_tokens=4096 设置。
换模型包之前,检查这三件事
- 是否带视觉投影器? 图像推理需要它。prithivMLmods 的 GGUF 包另需
Xiaomi-OCR-0.mmproj-bf16.gguf;xzl01 包使用 F16 视觉投影器。 - 是否沿用正确的推理设置? Ollama 的 MCP 和 Demo 已处理对应设置,单独拉取权重没有。
- 是否把原模型分数套给了转换版? 官方没有评估上述社区 GGUF 转换的精度;社区 NInfer BF16 的速度与输出对比也应到对应包页面查看。
如果你的目标是文档转结构化内容,就从整页解析开始;如果目标是找字段,再尝试 KIE 和指定 JSON schema。先把一张图的输出看明白,再扩大任务规模。
官方资料
- Xiaomi-OCR-0 官方模型卡:训练路线、成绩、示例和许可证(Apache 2.0)。
- GitHub 中文 README:项目说明。
- Ollama 使用指南:MCP、Demo 和区域模式配置。
- 技术报告:数据引擎与训练实验细节。
最新博客文章
追踪 Vibe Coding Tools 最新的对比、测评与实战技巧。
DeepSeek Super Agent 能否调度多个 Agent?用 Router、Worker 和子 Agent 的分工、简单任务示例及 3 步上手路线,讲清它适合谁、能做什么,以及怎样检查结果。
Dessa AI voice model 已公布研究预览,但尚未向普通用户开放。了解官方录音怎么听、四类潜在用途,以及模型下载、API、中文支持和本地运行的当前状态。
按编辑器、终端、自选模型和云端部署场景比较 AI 编程工具,提供官方依据、成本核对方法及可重复的 Next.js 评估任务。